
Digital Asset Management für KI-Bilder mit SharePoint Online
Architektur, Governance und Automatisierung für KI-generierte Bilder im UnternehmenseinsatzDigital Asset Management für KI-Bilder mit SharePoint Online und Power Platform
Niko sortiert die Ausbeute der Nacht: links das Archiv, rechts der Graph, der es gefüllt hat. Das Beitragsbild ist KI-generiert und trägt das Badge, das im Text gefordert wird.
|
Wissen Alle Grundlagen zur KI-Bildgenerierung an einem Ort: Verfahren, Werkzeuge, Governance. |
Beratung Architektur, Metadatenmodell und Freigabefluss gemeinsam aufsetzen, statt Jahre zu planen. |
Schulung Deine Leute lernen Prompt, Seed, Freigabe und Pflege am eigenen Tenant. |
|---|
Es gibt einen Moment in jedem Projekt, in dem der Kunde still wird. Bei mir war es der Moment, in dem wir den OneDrive-Ordner eines Marketingteams ausgemessen haben: 186.000 PNG-Dateien, 1,4 Terabyte, entstanden in vier Monaten. In Benutzung: elf Bilder. Elf. Der Rest waren Varianten, Zwischenstände, Upscales von Zwischenständen und dreiundzwanzig Versuche, einer Frau in einem Laborkittel eine Hand mit fünf Fingern zu verpassen. Niemand hatte etwas falsch gemacht. Alle hatten genau das getan, wofür Bildgeneratoren gebaut sind: erzeugen, vergleichen, nochmal erzeugen.
Genau das ist der Punkt. Ein Digital Asset Management mit SharePoint Online für KI-Bilder ist kein Dateiablage-Projekt mit anderem Namen. Es ist die Antwort auf eine Produktionsmaschine, die schneller Material ausspuckt, als ein Mensch es bewerten kann. Wenn du diese Maschine ohne Katalog betreibst, bekommst du nicht Unordnung – du bekommst Unordnung mit Zinseszins.
|
FAKTEN ROT steht in der Informationsverwaltung für Redundant, Obsolet, Trivial. Bei klassischen Dateiablagen liegt der ROT-Anteil erfahrungsgemäß bei einem Drittel bis zur Hälfte des Bestands. Bei KI-Bildern kippt dieses Verhältnis. Eine einzige Generierung mit batch_size 8 und vier Seed-Durchläufen erzeugt 32 Dateien, von denen im Regelfall eine überlebt. Der ROT-Anteil liegt damit strukturell jenseits von 95 Prozent – nicht als Betriebsunfall, sondern als Konstruktionsprinzip. Die Konsequenz: Ein DAM für KI-Bilder muss nicht in erster Linie speichern. Es muss aussortieren – und zwar an einer Stelle, an der die Entscheidung noch billig ist. |
|---|
Dieser Beitrag zeigt dir, wie das konkret aussieht: welche Bibliotheken du anlegst, welche Spalten du brauchst, wie die Werte aus den PNG-Dateien in diese Spalten kommen, wie der Freigabefluss in Power Automate gebaut ist und wie du Suche und Aufbewahrung so einstellst, dass das Archiv in zwei Jahren noch benutzbar ist. Die Grundlagen der Bilderzeugung selbst – Diffusion, Modelle, Parameter – findest du in der Themenübersicht KI-Bildgenerierung. Hier geht es um das, was danach passiert.
Das ROT-Problem bei KI-Bildern: warum Dubletten hier anders funktionieren
Eine Dublette im klassischen Sinn ist eine Datei, die es zweimal gibt. Byteidentisch, gleicher Hash, eindeutig erkennbar. SharePoint Online kann das im Upload-Dialog abfangen, und jedes Migrationswerkzeug findet solche Paare zuverlässig. Damit ist das Problem für Verträge und Präsentationen weitgehend gelöst.
Bei KI-Bildern hilft dir das fast nichts. Deine Dubletten sind nicht byteidentisch, sie sind semantisch identisch. Dasselbe Motiv, gleicher Prompt, gleiches Modell, nur ein anderer Seed oder zwei Sampling-Schritte mehr. Für den Dateisystem-Hash sind das völlig verschiedene Dateien. Für jeden Menschen, der das Archiv durchsucht, sind es sechsunddreißig Mal dasselbe Bild mit minimal anderem Lichteinfall.
Drei Sorten Redundanz, die du auseinanderhalten musst
|
Sorte |
Woran du sie erkennst |
Was dagegen hilft |
|---|---|---|
|
Exakte Dublette |
Gleicher Hash über die Bilddaten. Entsteht durch Kopieren, erneutes Herunterladen, Synchronisierungsfehler. |
Hash beim Eingang bilden, in einer indizierten Spalte ablegen, Treffer ablehnen. |
|
Variantenschwarm |
Gleicher Prompt und gleiches Modell, unterschiedlicher Seed oder unterschiedliche Parameter. Die typische Ausbeute eines Laufs. |
Gar nicht erst hochladen. Auswahl passiert vor dem Eingang, am Arbeitsplatz. Nur die Auswahl wandert ins DAM. |
|
Stiller Nachfolger |
Neues Bild ersetzt inhaltlich ein altes, ohne dass jemand das alte entwertet. Beide bleiben auffindbar. |
Feld für Vorgängerbild pflegen und den Vorgänger beim Freigeben des Nachfolgers automatisch auf abgelöst setzen. |
Die mittlere Zeile ist die wichtige, und sie ist gleichzeitig die unbequeme. Der Variantenschwarm darf nicht ins DAM. Nicht als Archivbestand, nicht als Sicherheitskopie, nicht als später-sortieren-wir-das. Wenn du bei batch_size und Reproduzierbarkeit gelesen hast, warum ein Lauf mit acht Bildern nicht acht gleichwertige Ergebnisse produziert, sondern acht Stichproben aus demselben Suchraum, dann ist klar, warum: Du archivierst keine Ergebnisse, du archivierst Rauschen um ein Ergebnis herum.
|
WICHTIG Der Seed macht den Variantenschwarm überflüssig. Wenn Prompt, Modell, Seed, Sampler, Schrittzahl und Guidance vollständig dokumentiert sind, kannst du jede verworfene Variante jederzeit neu erzeugen – in Sekunden, ohne Speicherplatz. Das ist der eigentliche Trick eines DAM für KI-Bilder: Du speicherst nicht die Bilder, du speicherst die Rezepte. Das Bild ist nur das Ergebnis, das zufällig gerade gebraucht wird. |
|---|
Damit das trägt, muss die Reproduzierbarkeit tatsächlich gegeben sein. Sie ist es, solange Modellgewichte, Software-Version und Hardware-Pfad stabil bleiben. Wechselst du die Grafikkartengeneration oder aktualisierst du den Kern deiner Umgebung, kann derselbe Seed minimal abweichende Bilder liefern. Das ist kein Grund, das Prinzip aufzugeben – es ist ein Grund, die Software-Version mit ins Metadatenmodell zu nehmen und wirklich benutzte Bilder als Datei zu behalten. Was im Einsatz ist, bleibt liegen. Was nur Kandidat war, wird zum Rezept eingedampft. Wie eng der Zusammenhang zwischen Startwert und Ergebnis ist, steht ausführlich in Der Seed bei der KI-Bildgenerierung.
Warum die Speicherfrage trotzdem nicht das Hauptproblem ist
Platz ist selten der Engpass. SharePoint Online bringt pro Organisation 1 Terabyte Grundkontingent plus 10 Gigabyte je erworbener Lizenz mit, eine einzelne Website darf bis zu 25 Terabyte belegen, und zusätzlicher Speicher lässt sich dazukaufen. Eine Bibliothek fasst bis zu 30 Millionen Dateien und Ordner. Rein rechnerisch bekommst du deinen Variantenschwarm also unter.
Das Problem ist die Auffindbarkeit. Und die bricht lange vor dem Speicherlimit zusammen: Das Listenansichtslimit von 5.000 Elementen pro Abfrage ist in SharePoint Online fest und unveränderlich. Ab 100.000 Elementen in einer Bibliothek kannst du die Berechtigungsvererbung auf Bibliotheksebene nicht mehr aufbrechen. Und wer die Bibliothek synchronisiert, sollte laut Microsoft die Marke von 300.000 Dateien nicht überschreiten, sonst wird die Synchronisierung unzuverlässig. Diese Zahlen sind keine Katastrophenschwellen, sondern Planungsgrößen – und sie entscheiden, wie du deine Bibliotheken schneidest.
|
WARNUNG Der häufigste Baufehler: eine einzige Bibliothek namens „KI-Bilder“, in die alles fließt, und ein Ordnerbaum nach Jahr und Kampagne obendrauf. Nach neun Monaten hat diese Bibliothek 400.000 Elemente, jede gefilterte Ansicht läuft ins Ansichtslimit, und die Berechtigungen lassen sich nicht mehr sauber trennen. Die Reparatur ist teuer, weil du beim Verschieben zwischen Bibliotheken Versionsverläufe, Freigabelinks und teilweise Metadaten verlierst. Schneide die Struktur richtig, bevor die erste Datei drin liegt. |
|---|
Bibliotheksstruktur: drei Stufen statt einer Halde
Die Struktur, die sich bei mir in mehreren Projekten durchgesetzt hat, trennt nach Reifegrad, nicht nach Thema. Thema ist eine Spalte. Reifegrad ist eine Bibliothek, weil sich daran Berechtigungen, Versionierung, Aufbewahrung und Freigabefähigkeit unterscheiden – und genau diese vier Dinge kannst du in SharePoint Online sinnvoll nur auf Bibliotheks- oder Websiteebene steuern.
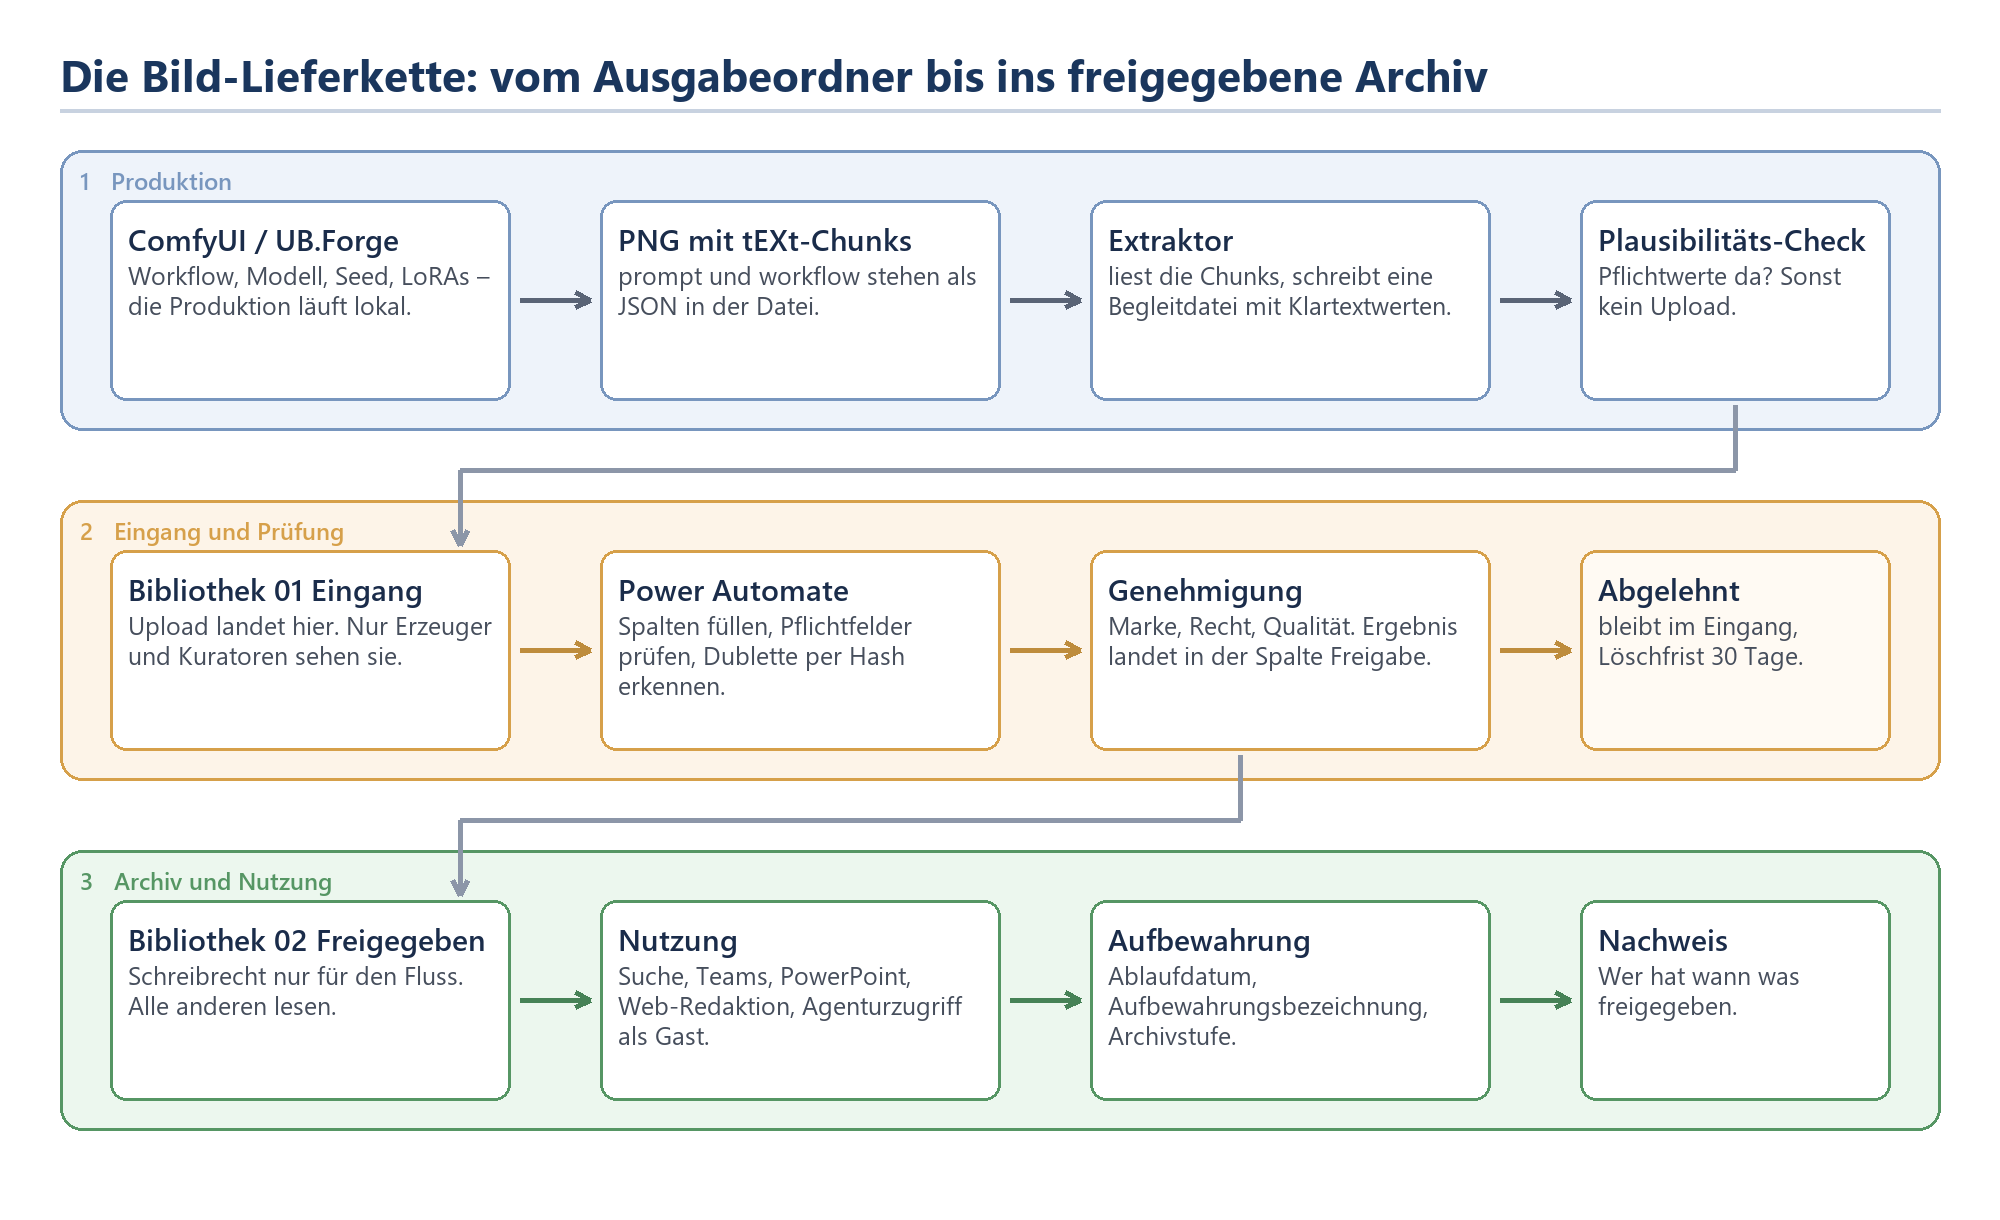
Skizze 1: Die drei Stufen und was zwischen ihnen passiert. Die Aussortierung findet in Stufe 1 statt, solange sie noch nichts kostet.
|
Bibliothek |
Was hineingehört |
Schreibrecht |
Versionierung |
Aufbewahrung |
|---|---|---|---|---|
|
00 Werkbank |
Nichts. Diese Stufe liegt bewusst außerhalb von SharePoint – auf der Maschine, die generiert. |
Der Mensch am Gerät |
keine |
Ordner wird nach Abschluss des Laufs geleert |
|
01 Eingang |
Die Auswahl aus einem Lauf. Vollständige Metadaten, aber noch keine Freigabe. |
Erzeuger und Kuratoren |
an, automatische Grenzen |
Abgelehntes nach 30 Tagen löschen |
|
02 Freigegeben |
Was im Unternehmen benutzt werden darf. Eine Datei je Motiv, keine Varianten. |
nur der Genehmigungsfluss |
an, Hauptversionen |
Aufbewahrungsbezeichnung mit Ablaufereignis |
|
03 Abgelöst |
Ehemals freigegebene Bilder, die ersetzt oder deren Rechte abgelaufen sind. |
nur Administration |
an |
kalte Archivstufe oder Löschung |
Warum die Werkbank draußen bleibt
Die Versuchung ist groß, den Ausgabeordner des Generators einfach per Synchronisierung in SharePoint zu spiegeln. Tu es nicht. Der Ausgabeordner füllt sich im Minutentakt, die Synchronisierung läuft dir in die Empfehlungsgrenze, und jede einzelne Verwerfung kostet dich einen Löschvorgang samt Papierkorb-Speicher. Der Papierkorb zählt gegen dein Speicherkontingent – das vergessen erstaunlich viele.
Stattdessen: Der Generator schreibt lokal, der Mensch wählt lokal aus, und erst die Auswahl geht hoch. Wenn du deine Erzeugung so aufgebaut hast, wie ich es in Aufbau einer skalierbaren Bild-Maschine mit ComfyUI und Flux beschrieben habe, hast du dafür ohnehin schon einen sauberen Ausgabepfad je Workflow und Datum. Der Übergabepunkt ins DAM ist dann ein bewusster Schritt und kein Nebeneffekt einer Ordnersynchronisierung.
|
TIPP Baue den Upload als Skript oder als kleine Anwendung, nicht als Drag-and-drop in den Browser. Das Skript liest die Metadaten aus der Datei, prüft die Pflichtfelder, bildet den Hash und legt beides zusammen ab. Damit ist der Eingang von vornherein sauber, und niemand muss zwölf Spalten von Hand tippen. Wenn die Produktion über einen Workflow-Dienst läuft, gehört dieser Plausibilitäts-Check dorthin: UB.Forge prüft vor dem Export, ob Prompt, Seed, Modell und Workflow-Version vollständig sind, und verweigert die Übergabe, wenn ein Pflichtwert fehlt. |
|---|
Eine Website oder mehrere
Für ein einzelnes Team reicht eine Kommunikationswebsite mit den vier Bibliotheken. Sobald mehrere Bereiche eigene Bildproduktion betreiben, wird es eine Website je Bereich, verbunden über eine Hubwebsite. Der Grund ist nicht Ästhetik, sondern Berechtigung: Die Marketingabteilung soll die Rohentwürfe der Produktentwicklung nicht sehen, die Personalabteilung ihre Bewerbermotive nicht mit allen teilen. Der Hub sorgt dafür, dass die Suche trotzdem über alles läuft, was die suchende Person sehen darf.
Zwei Grenzen für die Planung: pro Websitesammlung sind 2.000 Listen und Bibliotheken zusammen möglich, und die Organisation ist auf 2.000 Hubwebsites begrenzt. Das reicht für jedes realistische Szenario. Kritischer ist die Empfehlung, pro Liste oder Bibliothek höchstens 5.000 eindeutige Berechtigungseinträge zu führen – wer anfängt, einzelnen Bildern eigene Rechte zu geben, landet sehr schnell in einem Zustand, den niemand mehr überblickt.
Das Spaltenmodell: Prompt, Seed, Modell, LoRAs, Lizenz, Freigabe
Jetzt kommt der Teil, an dem sich ein DAM für KI-Bilder von jedem anderen Medienarchiv unterscheidet. Ein Foto braucht Fotograf, Ort, Datum und Rechtelage. Ein KI-Bild braucht das auch – und zusätzlich das vollständige Rezept, mit dem es entstanden ist. Ohne dieses Rezept ist das Bild ein Einzelstück, das niemand fortschreiben kann.
|
Spalte |
Typ in SharePoint |
Pflicht |
Wozu du sie brauchst |
|---|---|---|---|
|
Prompt |
Mehrere Textzeilen, unformatiert |
ja |
Wiederverwendung, Varianten, Nachweis gegenüber der Rechtsabteilung |
|
Negativ-Prompt |
Mehrere Textzeilen |
nein |
Bei Modellen mit klassischer Guidance nötig, bei destillierten Modellen oft leer |
|
Seed |
Eine Textzeile |
ja |
Als Text, nicht als Zahl – 64-Bit-Werte überschreiten die sichere Zahlengenauigkeit |
|
Modell / Checkpoint |
Verwaltete Metadaten |
ja |
Ohne das Modell ist der Seed wertlos. Kontrolliertes Vokabular verhindert Schreibvarianten |
|
Modell-Prüfsumme |
Eine Textzeile |
empfohlen |
Gleicher Dateiname heißt nicht gleiche Gewichte. Die Prüfsumme ist die einzige harte Kennung |
|
LoRAs mit Gewicht |
Mehrere Textzeilen |
ja, wenn benutzt |
Name und Stärke je Adapter, in der Reihenfolge der Anwendung |
|
Sampler / Scheduler |
Auswahl |
ja |
Gehört zum reproduzierbaren Rezept |
|
Schritte / Guidance |
Zahl / Zahl |
ja |
Die beiden Stellschrauben, an denen später am häufigsten gedreht wird |
|
Auflösung |
Eine Textzeile |
ja |
Ausgangsauflösung, nicht die des hochskalierten Endergebnisses |
|
Workflow-Version |
Verwaltete Metadaten |
ja |
Damit du weißt, welcher Graph das Bild erzeugt hat |
|
Bild-Hash |
Eine Textzeile, indiziert |
automatisch |
Dublettenerkennung im Eingang |
|
Kennzeichnung |
Auswahl |
ja |
Vollsynthetisch, KI-bearbeitet oder fotografisch – die Basis für jede Transparenzpflicht |
|
Rechtelage |
Auswahl |
ja |
Freie Nutzung, eingeschränkt, Personenbezug vorhanden, Markenbezug vorhanden |
|
Freigabe |
Auswahl |
ja |
Entwurf, in Prüfung, freigegeben, abgelehnt, abgelöst |
|
Gültig bis |
Datum |
nein |
Steuert Ablauf und Archivierung |
|
Vorgängerbild |
Hyperlink |
nein |
Verbindet den stillen Nachfolger mit dem, was er ersetzt |
Die drei Spalten, an denen die meisten Modelle scheitern
Der Seed als Zahl. Klingt logisch, ist es aber nicht. Seeds sind vorzeichenlose 64-Bit-Ganzzahlen, und sobald ein solcher Wert durch eine JavaScript-Schicht, eine Excel-Ansicht oder einen Power-Automate-Ausdruck läuft, kann er auf 15 bis 17 signifikante Stellen gerundet werden. Ein um eine Stelle verfälschter Seed erzeugt ein völlig anderes Bild. Nimm eine Textzeile und schreibe den Wert als Zeichenkette.
Das Modell als freies Textfeld. Nach sechs Wochen stehen in dieser Spalte „flux1-dev“, „FLUX.1 dev“, „flux_dev_fp8“ und „Flux Dev (unsere Version)“. Nimm verwaltete Metadaten mit einem gepflegten Begriffssatz. Und ergänze die Prüfsumme der Modelldatei, weil derselbe Dateiname bei unterschiedlicher Quantisierung unterschiedliche Bilder liefert. Warum Checkpoint, VAE und Quantisierung nicht dasselbe sind, steht in Checkpoints, Modelle und VAE.
Die LoRAs als Einzelfeld. Ein Bild benutzt selten nur einen Adapter. Typisch sind zwei bis vier: einer für den Stil, einer für das Produkt, einer für die Bildsprache der Marke. Entscheidend sind Name, Stärke und Reihenfolge – dieselben drei Adapter in anderer Reihenfolge geben ein anderes Bild. Schreibe sie als strukturierte Liste in ein mehrzeiliges Feld, eine Zeile je Adapter. Wenn dein Team eigene Adapter trainiert, gehört dort auch die Trainingsversion hinein; die Hintergründe dazu liefert Was ist ein LoRA?.
|
TIPP Verwaltete Metadaten sind in SharePoint Online großzügig dimensioniert: eine Million Begriffe, zwei Millionen Begriffsnamen, 1.000 globale Begriffssätze. Du wirst das nie ausreizen. Aber halte die Zahl der Begriffe trotzdem klein – Microsoft empfiehlt, in einer Spalte für verwaltete Metadaten höchstens 50 Begriffe als Vorgabewert zu setzen, sonst leidet die Suche. Fang mit zwölf Modellen und dreißig Stilbegriffen an. Was nach drei Monaten niemand benutzt hat, fliegt raus. |
|---|
Kennzeichnung und Rechtelage: die zwei Spalten, die dich retten
Seit dem 2. August 2026 gelten die Transparenzpflichten aus Artikel 50 der KI-Verordnung der Europäischen Union. Anbieter von Systemen, die synthetische Bilder, Videos oder Audiodaten erzeugen, müssen die Ausgabe maschinenlesbar als künstlich erzeugt oder manipuliert kennzeichnen. Für generative Systeme, die vor diesem Stichtag bereits im Markt waren, sieht die Omnibus-Einigung vom Mai 2026 eine Schonfrist bis zum 2. Dezember 2026 für die maschinenlesbare Markierung vor. Wer Bilder öffentlich einsetzt, die eine reale Person oder ein reales Ereignis erkennbar darstellen, hat zusätzlich eine Offenlegungspflicht gegenüber dem Publikum. Was das konkret für die Praxis bedeutet, steht im Briefing EU AI Act: Was seit dem 2. August 2026 gilt.
Für dein DAM heißt das zweierlei. Erstens: Die Spalte Kennzeichnung ist keine Kür, sie ist die Grundlage dafür, dass du bei einer Anfrage überhaupt auskunftsfähig bist. Zweitens: Du kannst dich nicht darauf verlassen, dass die technische Markierung in der Datei überlebt. Content Credentials nach dem C2PA-Standard – die aktuelle Spezifikation trägt die Versionsnummer 2.4 vom April 2026 – sind kryptografisch signierte Provenienzdaten, die viele Plattformen beim Hochladen schlicht entfernen. Microsoft versieht seit Februar 2026 KI-erzeugte Inhalte in Microsoft 365 mit solchen Angaben, und auch Bing und Designer kennzeichnen entsprechend. Microsofts eigener Bericht zur Medienintegrität aus demselben Monat sagt allerdings deutlich, dass weder Provenienzdaten noch Wasserzeichen noch Fingerabdruckverfahren für sich genommen ausreichen.
|
WARNUNG Verlasse dich nicht auf Metadaten in der Datei als alleinigen Nachweis. Ein Zuschnitt in einem beliebigen Bildbearbeitungsprogramm, ein Export über ein soziales Netzwerk oder eine Konvertierung nach JPEG kann die Provenienzdaten entfernen, ohne dass jemand es merkt. Der belastbare Nachweis ist die Datenbankspalte in deinem DAM, verbunden mit dem Versionsverlauf und dem Überwachungsprotokoll des Tenants. Die Datei ist die Kopie, der Katalog ist die Quelle. Woran man synthetische Bilder sonst noch erkennt, steht in |
|---|
Die Spalte Rechtelage ist die andere Hälfte. Sie unterscheidet mindestens vier Zustände: frei verwendbar, eingeschränkt verwendbar mit Bedingung, Personenbezug vorhanden, Markenbezug vorhanden. Der dritte Zustand ist der teure. Sobald ein Adapter auf echten Personen trainiert wurde oder ein Eingangsbild eine reale Person zeigt, hast du eine datenschutzrechtliche Frage am Hals, die niemand im Marketingteam beantworten kann. Wenn dein Katalog der Unternehmenswerte und Nachweise ohnehin in UB.Dossier gepflegt wird, ist das der natürliche Zubringer: Dort liegen die Einwilligungen, Modellfreigaben und Markenrechte, und die SharePoint-Spalte trägt nur noch die Verknüpfung dorthin.
Metadaten-Mapping: von den PNG-Daten in die SharePoint-Spalten
Die gute Nachricht zuerst: Die meisten Werte, die du brauchst, stecken bereits in der Datei. Die schlechte: SharePoint Online liest sie nicht.
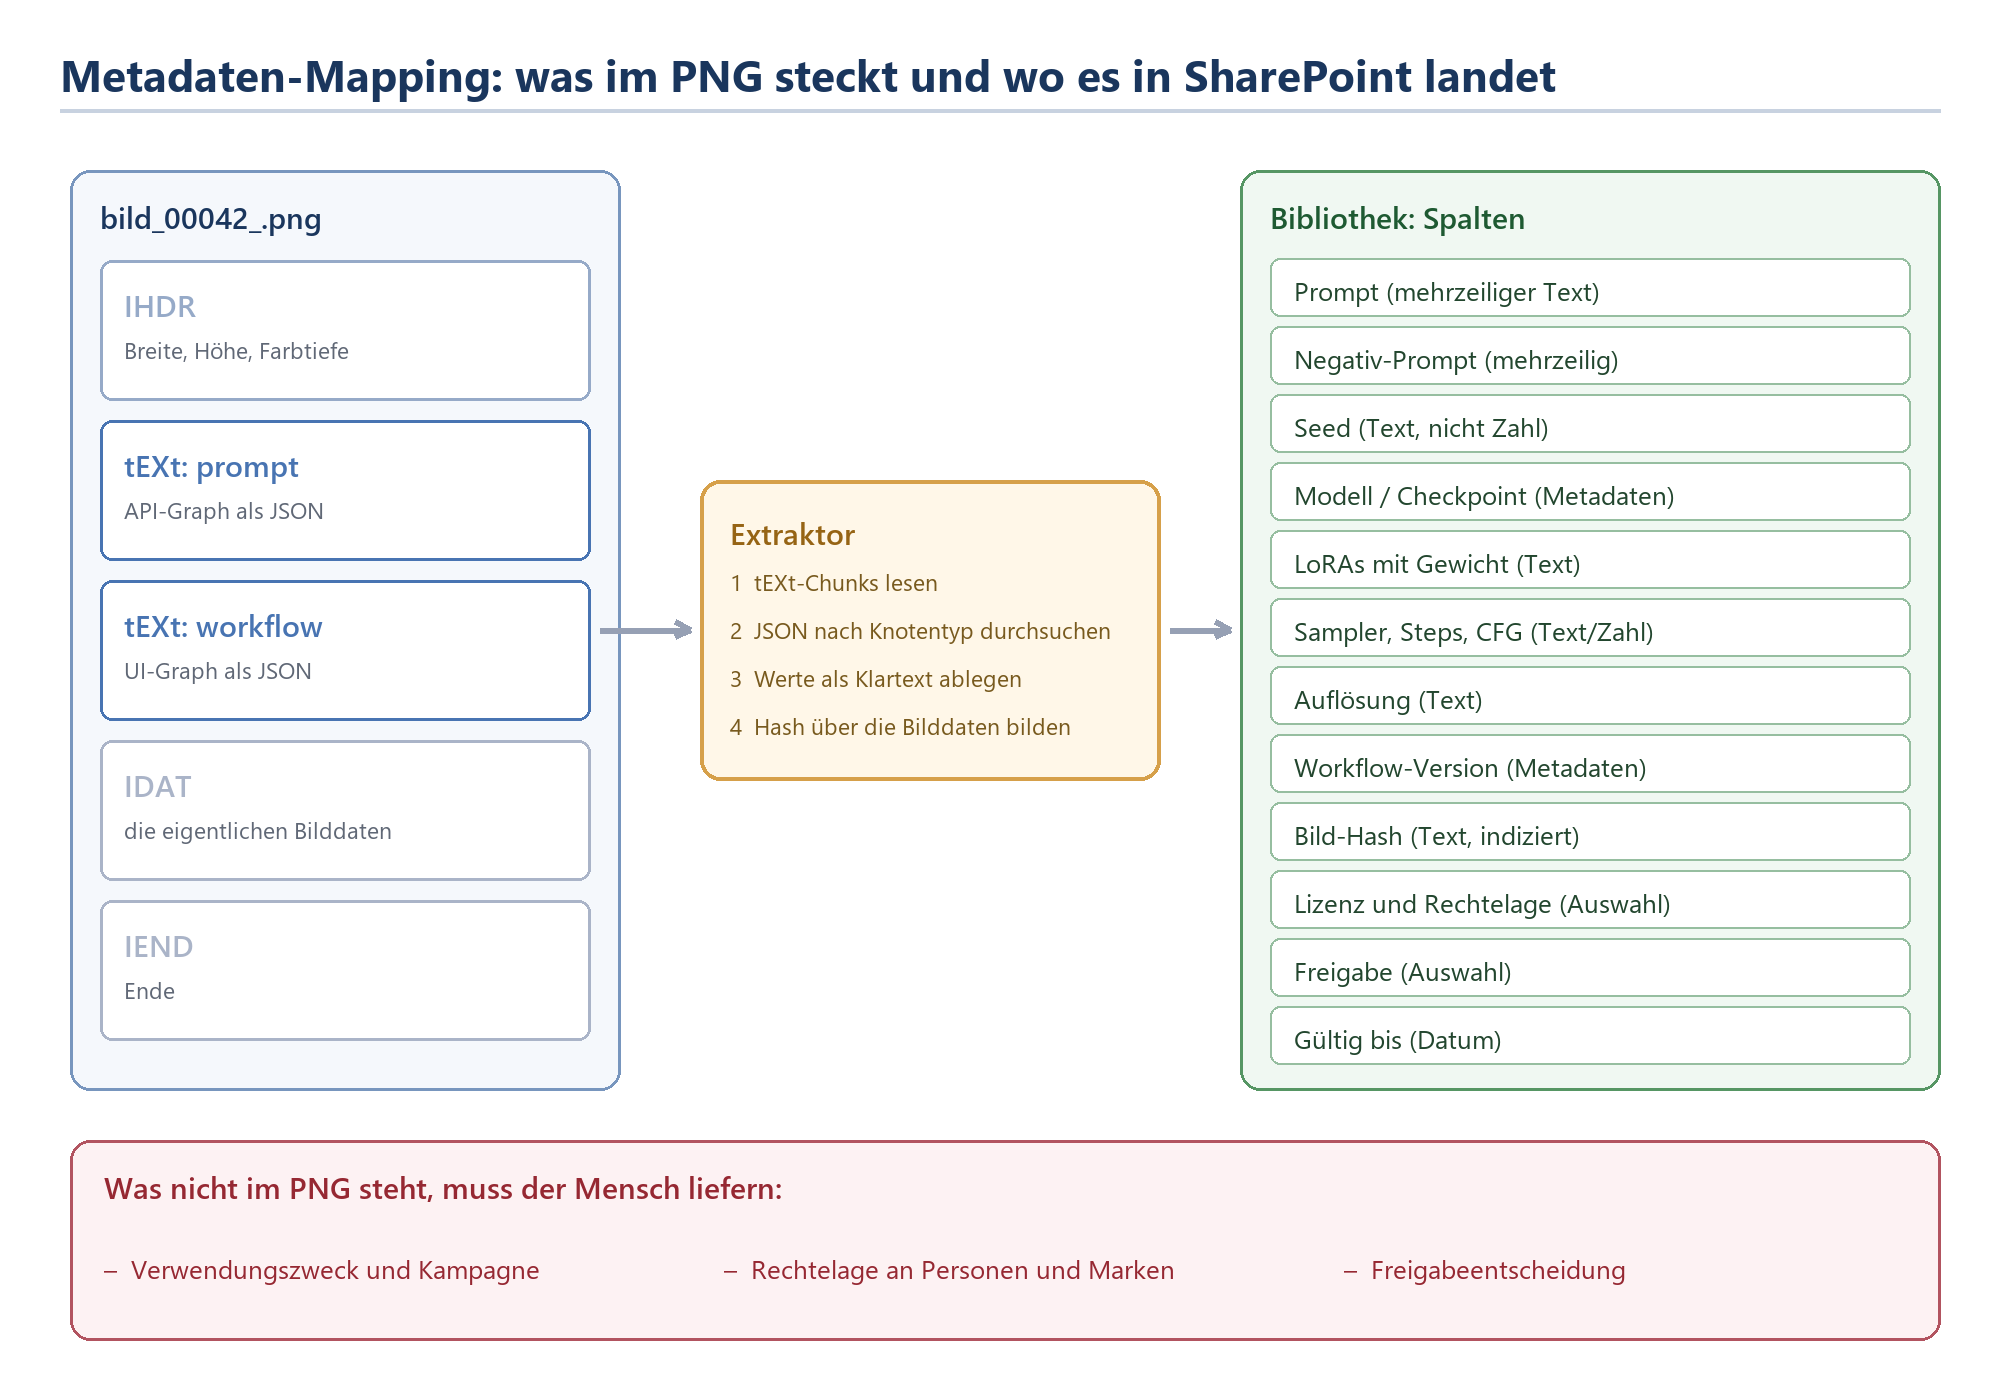
Skizze 2: Was das PNG mitbringt, was der Extraktor daraus macht und was trotzdem der Mensch beisteuern muss.
Was im PNG steht und warum SharePoint es ignoriert
Eine PNG-Datei besteht aus Abschnitten, sogenannten Chunks. Neben den Bilddaten gibt es textuelle Chunks vom Typ tEXt, die aus einem Schlüsselwort von bis zu 79 Byte, einem Nullbyte und einem Textteil bestehen. Genau dort legen die gängigen Node-Umgebungen ihre Informationen ab: unter dem Schlüsselwort prompt den ausführbaren Graphen als JSON, unter workflow den vollständigen Graphen der Benutzeroberfläche. In diesem JSON stehen Modellname, Seed, Sampler, Scheduler, Schrittzahl, Guidance, Auflösung und sämtliche Adapter mit ihren Gewichten.
SharePoint Online wertet bei Bilddateien die klassischen EXIF-Angaben aus – Aufnahmedatum, Kameramodell, Belichtungsdaten. PNG kennt EXIF traditionell nicht, und die tEXt-Chunks liest die Plattform nicht aus. Das ist kein Fehler, das ist schlicht nicht vorgesehen. Du brauchst also einen Zwischenschritt.
|
FAKTEN Der Textteil eines tEXt-Chunks ist nach Standard in Latin-1 kodiert. Umlaute in Prompts überleben das, Emojis und asiatische Schriftzeichen nicht zuverlässig – dafür ist der iTXt-Chunk mit UTF-8 vorgesehen, den nicht jede Umgebung schreibt. Praktische Folge: Prüfe beim Extrahieren, ob der Prompt sauber dekodiert wurde, und normalisiere auf UTF-8, bevor du ihn nach SharePoint schreibst. Sonst stehen in deiner Prompt-Spalte irgendwann Zeichenfolgen, die niemand mehr lesen kann. |
|---|
Die drei Wege, den Wert in die Spalte zu bekommen
|
Weg |
Wie er funktioniert |
Wann er passt |
Haken |
|---|---|---|---|
|
Extraktor beim Upload |
Ein Skript liest die Chunks, baut daraus Spaltenwerte und lädt Datei und Metadaten in einem Vorgang hoch. |
Standardfall. Sauber, schnell, keine Nacharbeit. |
Braucht einmal Entwicklungsarbeit und eine Anmeldung mit passenden Rechten. |
|
Begleitdatei plus Fluss |
Der Generator schreibt neben das Bild eine JSON-Datei. Ein Fluss liest sie und schreibt die Werte in die Spalten. |
Wenn der Upload aus einem fremden Prozess kommt, den du nicht anfassen darfst. |
Zwei Dateien müssen zusammenfinden. Reihenfolge und Namenskonvention sind kritisch. |
|
Nachträglich über die Schnittstelle |
Ein Dienst liest die schon abgelegten Dateien und ergänzt die Spalten im Nachgang. |
Für Altbestände, die schon im Tenant liegen. |
Die Datei muss vollständig heruntergeladen werden. Bei Zehntausenden Bildern dauert das. |
In der Praxis ist der erste Weg der richtige und die anderen beiden sind Reparaturen. Wenn dein Produktionsprozess über UB.Forge läuft, sitzt der Extraktor ohnehin im Workflow: Der Graph wird dort verwaltet, die Ausgabe kennt ihre eigenen Parameter, und die Übergabe ins DAM ist ein Schritt am Ende der Kette statt ein nachgelagerter Rateversuch.
Automatische Verschlagwortung: was die Plattform selbst kann
SharePoint bringt eine eigene Bildverschlagwortung mit. Sie schreibt beschreibende Stichwörter in eine Spalte für verwaltete Metadaten namens „Image Tags“, unterstützt die gängigen Formate einschließlich zahlreicher Rohdatenformate und braucht dafür kein eigenes Modell. Drei Eigenschaften solltest du kennen, bevor du damit planst: Die Stichwörter erscheinen frühestens nach fünf Minuten und spätestens nach 24 Stunden. Bereits vorhandene Bilder werden beim Einschalten nicht nachverarbeitet – nur neu hochgeladene. Und die Spalte ist bearbeitbar, du kannst also korrigieren und ergänzen.
Abgerechnet wird nutzungsabhängig über die verbrauchsbasierte Abrechnung der Dokumentverarbeitung in Microsoft 365. Das kostenfreie Einstiegskontingent, mit dem sich die Funktion erproben ließ, lief bis Juni 2026 – wer sie heute einschaltet, zahlt pro verarbeitetem Bild. Rechne das vorher durch: Bei einem Eingang von ein paar hundert freigegebenen Bildern im Monat ist das Kleingeld, bei einem ungefilterten Variantenschwarm ist es ein Grund, die Filterung endlich einzubauen.
|
WICHTIG Die automatische Verschlagwortung ersetzt dein Spaltenmodell nicht. Sie erkennt, was auf dem Bild zu sehen ist – Personen, Objekte, Orte. Sie weiß nichts über Seed, Modell, Adapter, Lizenz oder Freigabe. Beides zusammen ergibt erst ein brauchbares Archiv: die maschinelle Beschreibung für die Suche nach Inhalt, dein Spaltenmodell für die Suche nach Herkunft und Rechtslage. |
|---|
Für die Beschreibungstexte selbst lohnt ein zweiter Blick auf Sprachmodelle. Eine gute Bildbeschreibung in ganzen Sätzen macht die Volltextsuche deutlich treffsicherer als eine Liste von Schlagwörtern, und sie ist gleichzeitig der Alternativtext für barrierefreie Verwendung. Wie sich solche Modelle im Unternehmen sauber einbinden lassen, behandle ich unter Claude im Unternehmen. Der Weg dorthin führt über einen Fluss, der das Bild an das Modell übergibt und die Antwort in die Beschreibungsspalte schreibt – mit einem Menschen, der stichprobenartig gegenliest.
Der Freigabefluss mit Power Automate
Der Freigabefluss ist das Herzstück, und er ist gleichzeitig die Stelle, an der die meisten Projekte zu viel wollen. Ein Fluss, der siebzehn Bedingungen prüft, drei Genehmigungsstufen durchläuft und bei jedem Zwischenschritt eine Nachricht verschickt, wird nach vier Wochen abgeschaltet. Ein Fluss, der eine Sache zuverlässig tut, läuft Jahre.
Der Ablauf in sechs Schritten
Auslöser: Wenn eine Datei in der Bibliothek 01 Eingang erstellt wurde. Nutze die Variante, die nur die Eigenschaften liest – sie ist deutlich schneller, weil der Dateiinhalt nicht übertragen wird.
Vollständigkeit prüfen: Sind Prompt, Seed, Modell, Workflow-Version und Kennzeichnung gefüllt? Wenn nein, Datei auf Status Entwurf setzen und eine Nachricht an die Person schicken, die hochgeladen hat. Kein Abbruch, keine Fehlermeldung – eine Aufforderung.
Dublette erkennen: Bild-Hash gegen die indizierte Spalte in 02 Freigegeben prüfen. Treffer bedeutet Ablehnung mit Verweis auf das vorhandene Bild.
Genehmigung starten: Eine Genehmigungsaufgabe an die zuständige Rolle, mit Vorschaubild, Prompt und Rechtelage direkt in der Benachrichtigung. Wer erst die Bibliothek öffnen muss, entscheidet langsamer.
Bei Zustimmung: Datei nach 02 Freigegeben verschieben, Freigabe auf freigegeben setzen, Freigabedatum und freigebende Person schreiben. Wenn ein Vorgängerbild angegeben ist, dieses auf abgelöst setzen und nach 03 verschieben.
Bei Ablehnung: Begründung in eine Kommentarspalte schreiben, Status auf abgelehnt setzen, Datei im Eingang lassen. Die Aufbewahrungsregel räumt nach 30 Tagen auf.
|
WARNUNG Das Verschieben zwischen Bibliotheken ist nicht kostenlos. Versionsverläufe können dabei verlorengehen, bestehende Freigabelinks brechen, und bei sehr großen Beständen greifen Grenzen für Kopiervorgänge – Microsoft nennt 100 Gigabyte Gesamtvolumen und 30.000 Dateien je Vorgang. Für Einzeldateien im laufenden Betrieb ist das irrelevant. Für eine Migration von Zehntausenden Bildern in einem Rutsch ist es ein Planungsthema. Teile große Übernahmen in Pakete. |
|---|
Was du über die Lizenzierung wissen musst
Die Standardkonnektoren für SharePoint, Outlook, Teams und Genehmigungen sind in den Nutzungsrechten enthalten, die mit den gängigen Microsoft-365-Plänen kommen. Damit baust du den gesamten Freigabefluss ohne Zusatzlizenz. Sobald du Premiumkonnektoren einsetzt, eine eigene Schnittstelle ansprichst oder Dataverse als Ablage brauchst, brauchst du eine eigenständige Lizenz. Außerdem gelten Tagesgrenzen für Power-Platform-Anfragen, die von der Lizenz abhängen – ein Fluss, der bei jedem einzelnen Bild eines Variantenschwarms anspringt, läuft schneller dagegen, als dir lieb ist.
|
TIPP Lass den Fluss nicht pro Datei feuern, wenn ein Lauf zwanzig Dateien produziert. Sammle im Eingang und starte die Genehmigung einmal für eine Gruppe zusammengehöriger Bilder. Das spart Aufrufe, und wer genehmigt, sieht die Auswahl im Zusammenhang statt zwanzigmal einzeln. Technisch geht das über eine Sammlungs-Kennung, die der Extraktor beim Upload setzt: gleicher Lauf, gleiche Kennung. |
|---|
Eine Oberfläche für die Auswahl
Die Bibliotheksansicht von SharePoint ist für Dokumente gebaut. Für die Sichtung von dreißig Bildvarianten ist sie mühsam, auch mit Kachelansicht. Hier lohnt sich eine schlanke Anwendung aus Power Apps: Bild groß, Prompt daneben, drei Schaltflächen für annehmen, ablehnen, zurückstellen. Wer schon einmal eine Bildredaktion begleitet hat, weiß, dass diese drei Schaltflächen der ganze Arbeitsablauf sind.
Halte die Anwendung bewusst klein. Sie schreibt in dieselben Spalten, die auch der Fluss benutzt, und sie ist ersetzbar. Sobald eine Power App zur zwingenden Voraussetzung wird, um überhaupt an die Daten zu kommen, hast du dir ein zweites System gebaut, das gepflegt werden will. Das eigentliche System bleibt die Bibliothek.
Suche, Aufbewahrung und der Lebenszyklus
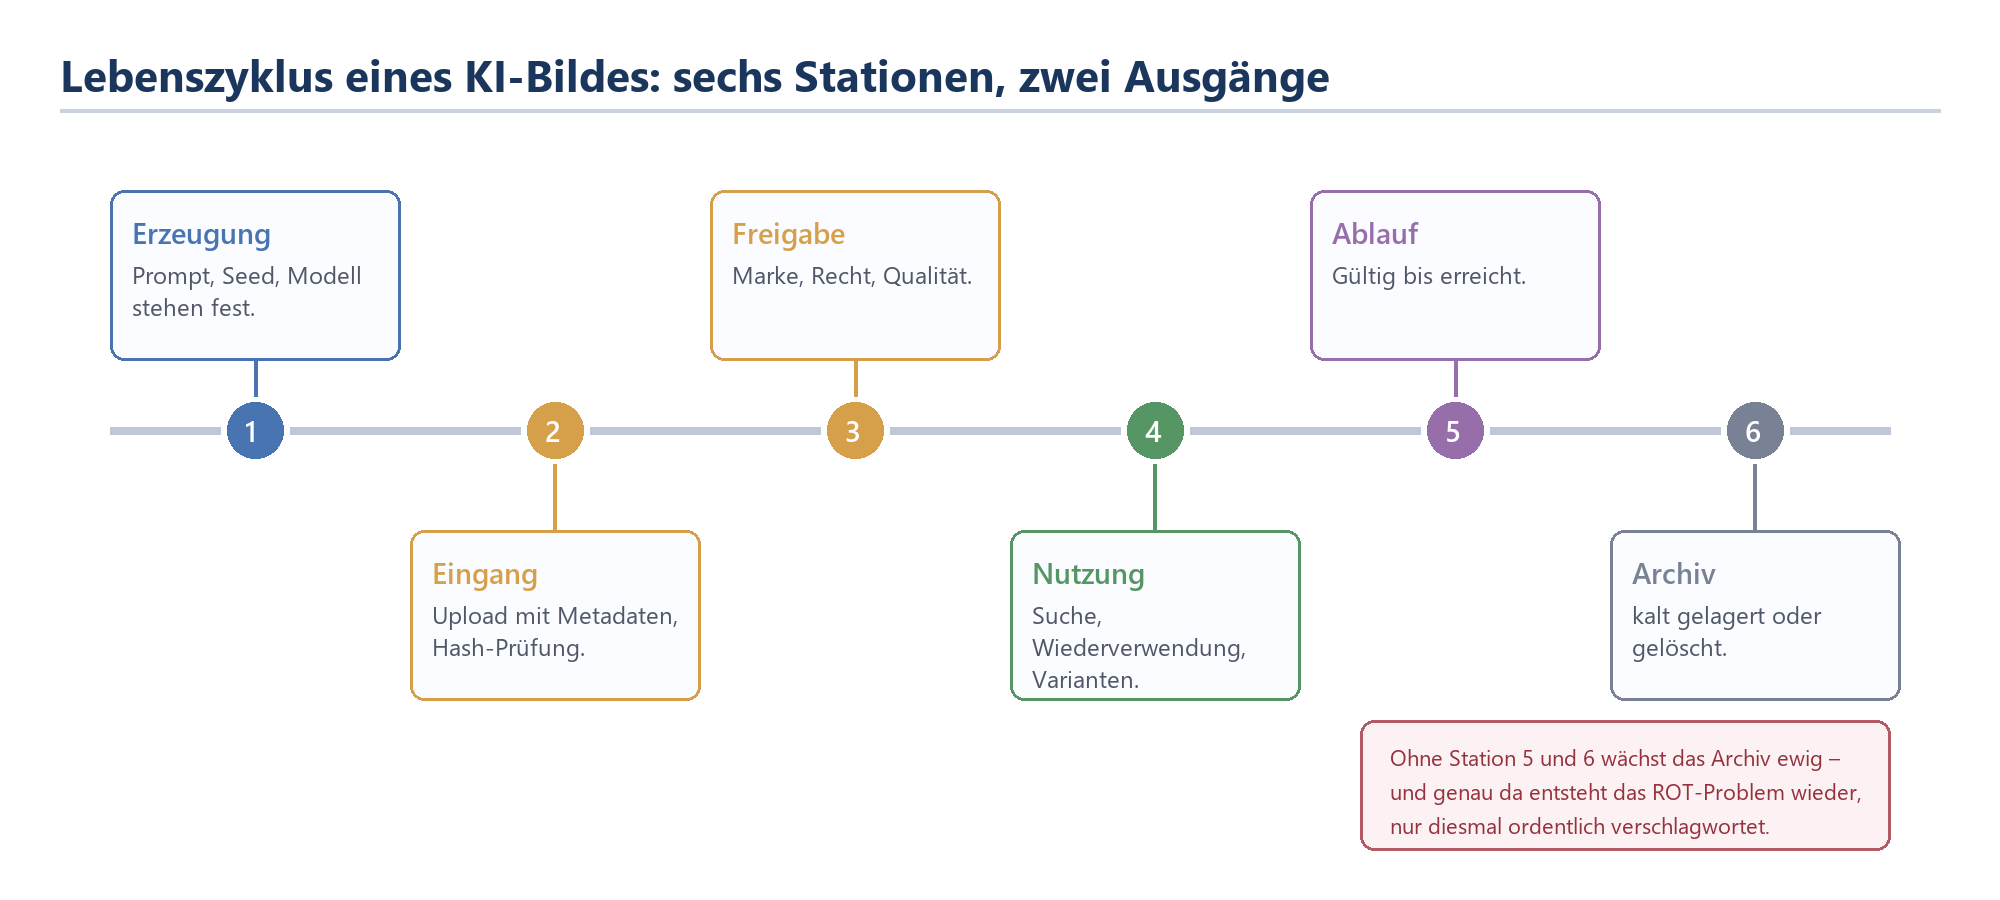
Skizze 3: Ohne die letzten beiden Stationen wird das gepflegte Archiv nur zu einer besser sortierten Halde.
Suche: Filter schlagen Freitext
Die Volltextsuche findet dein Bild über den Prompt, wenn der Prompt in einer indizierten Textspalte steht. Das klingt trivial, ist aber der eigentliche Gewinn: Wer „Laborkittel Sonnenlicht Fensterbank“ sucht, findet genau die Bilder, deren Prompt das enthält – auch wenn niemand sie je verschlagwortet hat. Ergänze das um eine Handvoll gefilterter Ansichten, die wirklich benutzt werden:
Freigegeben und gültig – die Standardansicht für alle, die nur Material suchen.
Läuft in 60 Tagen ab – die Arbeitsliste für die Bildredaktion.
Ohne Rechteklärung – der Rückstand, den niemand sehen will und den es trotzdem gibt.
Nach Modell – für den Tag, an dem ein Modell aus lizenzrechtlichen Gründen nicht mehr benutzt werden darf und du wissen musst, was davon betroffen ist.
Die letzte Ansicht ist die, die sich bisher jedes Mal bezahlt gemacht hat. Modelllizenzen ändern sich, Anbieter ziehen Versionen zurück, und irgendwann steht die Frage im Raum, welche Bilder mit welchem Modell erzeugt wurden. Ohne gepflegte Modellspalte ist die Antwort ein Achselzucken. Welche Modelle derzeit überhaupt zur Auswahl stehen und wie sie lizenziert sind, ist Thema in Die 15 wichtigsten Modelle zur lokalen Bildgenerierung.
|
WICHTIG Denke beim Ansichtsentwurf an das Listenansichtslimit von 5.000 Elementen. Eine Ansicht, die über eine indizierte Spalte filtert und dadurch unter dieser Grenze bleibt, funktioniert auch bei einer Bibliothek mit 300.000 Dateien. Eine Ansicht ohne Filter läuft schon bei 5.001 Elementen in den Fehler. Indiziere deshalb mindestens: Freigabe, Gültig bis, Modell und Bild-Hash. |
|---|
Versionierung: seit den automatischen Grenzen kein Kostentreiber mehr
Versionierung war lange ein Speicherfresser, weil jede gespeicherte Fassung vollständig zählte. Inzwischen gibt es automatische Grenzen für den Versionsverlauf: Ein Verfahren entscheidet, welche Fassungen aufbewahrungswürdig sind, und versieht ältere Fassungen mit einem sichtbaren Ablaufdatum im Versionsverlauf. Die jeweils aktuelle Fassung bekommt nie ein Ablaufdatum. Du kannst diese Grenzen auf Organisations-, Website- oder Bibliotheksebene setzen.
Für ein Bildarchiv ist das genau richtig. In der Bibliothek 02 Freigegeben wird selten überschrieben – und wenn doch, dann mit Absicht. Stell dort auf automatische Grenzen und lass die Plattform aufräumen. Das absolute Limit liegt ohnehin bei 50.000 Hauptversionen je Datei, was du bei Bildern nie erreichen wirst.
Aufbewahrung: das Ablaufdatum muss etwas auslösen
Ein Feld „Gültig bis“, das nichts bewirkt, ist Dekoration. Drei Mechanismen greifen ineinander:
|
Mechanismus |
Was er tut |
Wann du ihn nimmst |
|---|---|---|
|
Fluss auf Datumsbasis |
Läuft täglich, sucht Bilder mit erreichtem Ablaufdatum, setzt den Status auf abgelöst und verschiebt nach 03. |
Immer. Das ist die Arbeitsroutine, die den Katalog sauber hält. |
|
Aufbewahrungsbezeichnung |
Purview-Bezeichnung, die eine Mindestaufbewahrung erzwingt oder nach Ablauf eine Löschung auslöst. Auch ereignisbasiert möglich, etwa zum Vertragsende. |
Wenn eine gesetzliche oder vertragliche Frist im Spiel ist und du einen Nachweis brauchst, dass sie eingehalten wurde. |
|
Archivstufe |
Microsoft 365 Archive legt Inhalte in eine kalte Speicherstufe. Berechnet werden rund 0,05 US-Dollar je Gigabyte und Monat, und zwar nur, wenn aktiver plus archivierter Speicher das lizenzierte Kontingent übersteigt. |
Für Bestände, die du aus Nachweisgründen behalten musst, aber praktisch nie wieder öffnest. |
Zur Archivstufe zwei Einzelheiten, die in Planungsrunden regelmäßig für Erleichterung sorgen: Die frühere Reaktivierungsgebühr ist zum 31. März 2025 entfallen, das Zurückholen kostet also nichts mehr. Allerdings gibt es nach einer Reaktivierung eine Sperrfrist von vier Monaten, bevor derselbe Inhalt erneut archiviert werden darf. Die Archivierung auf Dateiebene statt ganzer Websites ist als Vorschauversion verfügbar – für ein Bildarchiv der interessantere Weg, weil du die Website aktiv lässt und nur die kalten Bestände verlagerst.
|
FAKTEN Aufbewahrungsrichtlinien und eDiscovery-Aufbewahrungen zählen gemeinsam gegen ein Tenant-Limit von 10.000 Compliance-Richtlinien, in das auch Verhinderung von Datenverlust, Informationsbarrieren und Vertraulichkeitsbezeichnungen einzahlen. Für SharePoint und OneDrive gilt zusätzlich: 13 Aufbewahrungen, wenn automatisch alle Websites einbezogen werden, 2.600 bei gezielter Auswahl einzelner Speicherorte. Wer für jede Kampagne eine eigene Richtlinie anlegt, läuft in diese Grenze. |
|---|
Der Punkt, an dem Löschen billiger ist als Behalten
Ich werde in Projekten regelmäßig gefragt, ob man das alles nicht einfach behalten kann, Speicher sei doch billig. Die ehrliche Antwort: Speicher ist billig, Suchen ist teuer. Jedes Bild, das im freigegebenen Archiv liegt und niemals benutzt wird, verschlechtert die Trefferqualität für alle anderen. Ab einer gewissen Menge hört das Team auf zu suchen und generiert lieber neu – und damit hast du genau den Zustand wieder, gegen den du angetreten bist, nur mit besseren Metadaten.
Die Faustregel, die sich bewährt hat: Ein Bild, das zwölf Monate lang nicht abgerufen wurde und dessen Rezept vollständig dokumentiert ist, gehört nicht ins freigegebene Archiv. Es gehört in die Archivstufe oder in den Papierkorb. Das Rezept bleibt – und damit die Möglichkeit, es jederzeit neu zu erzeugen. Genau dafür hast du die Spalten angelegt.
|
WEITERLESEN Wenn du die Erzeugungsseite dieser Kette aufbauen oder aufräumen willst: Aufbau einer skalierbaren Bild-Maschine mit ComfyUI und Flux › der Graph, der die Dateien liefert KI-Bildgenerierung im Unternehmen – Die strategische Alternative zur Cloud › die Entscheidung davor Cloud vs. lokale KI-Bildgenerierung › wo die Daten liegen und warum das zählt Markenkonsistente KI-generierte Bilder › wie ich das hier selbst handhabe Black Forest FLUX.2 in PowerPoint und Copilot › wo die freigegebenen Bilder am Ende landen |
|---|
Fazit
Ein Digital Asset Management mit SharePoint Online für KI-Bilder ist weniger Technikprojekt, als die Werkzeugliste vermuten lässt. Die Plattform kann alles, was du brauchst: Bibliotheken mit unterschiedlichen Rechten, verwaltete Metadaten, indizierte Spalten, Versionierung mit automatischen Grenzen, Aufbewahrung über Purview, eine kalte Archivstufe und einen Automatisierungsdienst, der im Standardumfang mitlizenziert ist. Was sie nicht kann, ist die Entscheidung, welches der 186.000 Bilder tatsächlich gebraucht wird.
Deshalb liegt der ganze Hebel an einer Stelle, die nach Kleinkram aussieht: an der Grenze zwischen Werkbank und Eingang. Alles, was diese Grenze überschreitet, hat eine Entscheidung hinter sich. Alles, was nicht überschreitet, existiert als Rezept weiter – Prompt, Seed, Modell, Adapter, Parameter – und lässt sich in Sekunden wiederherstellen. Wer diese eine Grenze diszipliniert zieht, bekommt ein Archiv, das nach zwei Jahren noch benutzbar ist. Wer sie nicht zieht, bekommt eine besser verschlagwortete Halde.
Ehrlich bei den Grenzen: SharePoint Online ist kein spezialisiertes Medienarchiv. Es erzeugt keine Ausgabeformate auf Zuruf, es hat keine eingebaute Anbindung an Kreativanwendungen, und ein Markenportal mit eigenem Erscheinungsbild für externe Partner baust du damit nicht nebenbei. Für KI-Bilder wiegt das leichter als für ein klassisches Fotoarchiv, weil das Endformat hier meist aus der Produktion kommt und nicht aus dem Archiv. Wer eine echte Bildredaktion mit Freisteller-Workflows und Formatvarianten betreibt, sollte den Vergleich mit einem Spezialsystem ernsthaft rechnen, statt ihn aus Bequemlichkeit zu überspringen.
Und noch ein Punkt, der in achtzehn Monaten anders aussehen wird als heute: Die Transparenzpflichten aus der KI-Verordnung sind seit August 2026 scharf, die maschinenlesbare Markierung ist für ältere Systeme bis Dezember 2026 gestundet, und die Provenienzstandards entwickeln sich schneller als die Werkzeuge, die sie umsetzen sollen. Ein Archiv, in dem die Kennzeichnung als Spalte geführt wird, überlebt diese Entwicklung. Ein Archiv, das sich auf Metadaten in der Datei verlässt, nicht.
Wenn du das aufsetzen willst, ohne den üblichen Umweg über ein halbes Jahr Konzeptphase: In der Beratung zur KI-Bildgenerierung bauen wir Bibliotheksschnitt, Spaltenmodell und Freigabefluss an deinem Tenant, statt sie zu beschreiben. Wenn dein Team die Pflege danach selbst tragen soll – und das soll es –, gehört die Schulung zur KI-Bildgenerierung dazu. Wie ich das Ganze bei mir selbst betreibe, steht in Dogfooding: Ich setze ein, was ich berate.
Häufige Fragen
Brauche ich wirklich SharePoint Online, oder tut es ein spezialisiertes DAM besser?
Wenn du Microsoft 365 ohnehin einsetzt, fängst du mit SharePoint Online an. Speicher, Rechteverwaltung, Suche, Aufbewahrung und Automatisierung sind bezahlt und betrieben. Für KI-Bilder ist der Funktionsabstand zu einem Spezialsystem kleiner als bei klassischen Fotoarchiven, weil der Schwerpunkt hier auf Herkunftsdaten und Freigabe liegt und nicht auf Bildbearbeitung. Ein Spezialsystem lohnt sich, wenn du automatische Formatvarianten, ein gebrandetes Partnerportal oder tiefe Anbindung an Kreativanwendungen brauchst. Dann aber bitte als bewusste Entscheidung mit gerechneten Kosten und nicht als Bauchgefühl.
Wie viele Bilder verkraftet eine Bibliothek in der Praxis?
Die harte Grenze liegt bei 30 Millionen Dateien und Ordnern je Bibliothek. Praktisch relevant sind andere Zahlen: Ab 100.000 Elementen lässt sich die Berechtigungsvererbung auf Bibliotheksebene nicht mehr aufbrechen, für die Synchronisierung empfiehlt Microsoft höchstens 300.000 Dateien, und jede einzelne Ansicht muss unter dem Ansichtslimit von 5.000 Elementen bleiben. Mit indizierten Spalten und gefilterten Ansichten sind ein paar hunderttausend freigegebene Bilder völlig unproblematisch. Wenn du dort hinkommst, ohne vorher auszusortieren, hast du allerdings ein anderes Problem.
Muss ich den Prompt wirklich vollständig speichern?
Ja, und zwar im Original, nicht gekürzt. Der Prompt ist gleichzeitig Rezept, Suchindex und Nachweis. Er erklärt, warum das Bild so aussieht, er macht es über die Volltextsuche auffindbar, und er ist im Zweifel das Dokument, das zeigt, dass niemand versucht hat, den Stil eines lebenden Künstlers nachzubauen. Nimm eine Spalte mit mehreren Textzeilen, unformatiert, und speichere Positiv- und Negativ-Prompt getrennt. Warum die Trennung sinnvoll ist und wie beide zusammenwirken, steht in Prompt und Negativ-Prompt in der KI-Bildgenerierung.
Warum soll der Seed eine Textspalte sein und keine Zahl?
Weil Seeds vorzeichenlose 64-Bit-Werte sind und damit größer als die Zahlengenauigkeit, die viele Zwischenschichten sicher abbilden. Ein Seed, der durch einen Browser, eine Tabellenansicht oder einen Ausdruck in einem Fluss läuft, kann still gerundet werden. Eine einzige veränderte Stelle erzeugt ein völlig anderes Bild – und du merkst es erst, wenn du das Rezept wieder verwenden willst. Textspalte, fertig.
Wie bekomme ich die Werte aus schon vorhandenen Bildern heraus?
Über einen nachgelagerten Lauf: Ein Dienst liest die Dateien aus der Bibliothek, extrahiert die tEXt-Chunks und schreibt die Spalten. Rechne mit Aufwand, weil jede Datei vollständig heruntergeladen werden muss. Und rechne mit Lücken: Bilder, die einmal durch ein Bildbearbeitungsprogramm gelaufen sind oder als JPEG exportiert wurden, haben ihre Herkunftsdaten meist verloren. Für solche Bestände gilt eine unbequeme Regel: Was sich nicht rekonstruieren lässt, wird als Herkunft unbekannt gekennzeichnet und bekommt ein Ablaufdatum. Es nachträglich zu erfinden, ist keine Option.
Was mache ich mit Bildern, bei denen der Prompt ein Ergebnis beschreibt, das gar nicht eingetreten ist?
Das passiert häufiger, als man denkt, und es ist kein Datenqualitätsproblem, sondern ein Modellverhalten: Teile des Prompts werden schlicht nicht umgesetzt. Für das Archiv heißt das, dass der Prompt allein kein verlässlicher Inhaltsindex ist. Nimm zusätzlich eine Beschreibungsspalte, die beschreibt, was tatsächlich auf dem Bild zu sehen ist. Die Hintergründe dazu behandelt Warum die KI den Prompt ignoriert.
Wie gehe ich mit externen Partnern und Agenturen um?
Gastzugriff über Entra-ID-Konten, begrenzt auf genau die Bibliothek, die sie brauchen – in der Regel nur 02 Freigegeben, lesend. Anonyme Freigabelinks sind für ein Archiv der falsche Weg, weil du nicht nachvollziehen kannst, wer zugegriffen hat, und weil der Link weiterwandert. Wenn eine Agentur selbst einliefern soll, bekommt sie eine eigene Eingangsbibliothek mit Schreibrecht und ohne Leserecht auf den Rest. Das ist kein Misstrauen, das ist die Grundvoraussetzung dafür, dass du bei einer Rechtefrage überhaupt etwas belegen kannst.
Ist die automatische Bildverschlagwortung von SharePoint ihr Geld wert?
Für inhaltliche Suche ja, für Herkunftsdaten nein. Sie schreibt beschreibende Stichwörter in die Spalte für verwaltete Metadaten und spart echte Tipparbeit. Sie verarbeitet aber nur neu hochgeladene Bilder, braucht zwischen fünf Minuten und 24 Stunden, und das kostenfreie Einstiegskontingent ist im Juni 2026 ausgelaufen – heute wird pro Bild nach Verbrauch abgerechnet. Genau deshalb gehört sie hinter die Freigabe und nicht davor: Du bezahlst nur für Bilder, die auch benutzt werden.
Was passiert mit dem Bild, wenn die Lizenz eines Modells sich ändert?
Dann brauchst du innerhalb von Minuten eine Liste aller Bilder, die mit diesem Modell erzeugt wurden. Genau dafür ist die Modellspalte als verwaltete Metadaten und nicht als Freitext angelegt. Filtere, markiere die Treffer, und entscheide dann bewusst: weiter verwenden, mit anderem Modell neu erzeugen oder zurückziehen. Das Rezept hast du – neu erzeugen ist bei vollständigen Metadaten oft die schnellste Lösung.
Reicht das Wasserzeichen in der Datei als Kennzeichnung nach der KI-Verordnung?
Als alleinige Grundlage nicht. Die maschinenlesbare Markierung ist seit August 2026 Pflicht für die Anbieter der erzeugenden Systeme, mit einer Stundung bis Dezember 2026 für Systeme, die vorher schon im Markt waren. Aber Provenienzdaten werden von vielen Plattformen beim Hochladen entfernt, und Microsoft selbst stellt fest, dass kein einzelnes Verfahren ausreicht. Dein belastbarer Nachweis ist die Spalte im Katalog, verbunden mit Versionsverlauf und Überwachungsprotokoll. Die Markierung in der Datei ist zusätzlich sinnvoll, ersetzt den Katalog aber nicht.
Wie halte ich die Metadatenpflege davon ab, zum Bürokratiemonster zu werden?
Indem der Mensch nur die Felder ausfüllt, die eine Maschine nicht kennen kann. Prompt, Seed, Modell, Adapter, Sampler, Schritte, Guidance, Auflösung und Workflow-Version kommen aus der Datei – das sind neun von sechzehn Spalten, die niemand tippt. Bleiben Verwendungszweck, Rechtelage, Kennzeichnung, Freigabe und gegebenenfalls Ablaufdatum und Vorgänger. Das sind fünf bis sechs Entscheidungen je Bild, die ohnehin jemand treffen muss. Wenn dein Team über Metadatenpflege klagt, ist meistens der Extraktor nicht gebaut worden.
Brauche ich eine eigene Rolle, die sich um das Archiv kümmert?
Eine Person mit Namen, ja. Eine Vollzeitstelle, fast nie. Es geht um wenige Stunden im Monat: Freigaben bearbeiten, Ablaufliste durchgehen, gelegentlich einen Begriff im Begriffssatz ergänzen, quartalsweise aussortieren. Entscheidend ist nicht der Umfang, sondern die Zuständigkeit. Ein Archiv ohne benannte verantwortliche Person verwahrlost in etwa neun Monaten – das ist erstaunlich reproduzierbar.
Kann ich Bilder direkt aus dem Archiv in PowerPoint oder Word einsetzen?
Ja, über die Bibliothek als Speicherort in den Office-Anwendungen, über Teams oder über die Suche. Für Präsentationen ist das der übliche Weg, und er hat den Vorteil, dass das Bild aus der freigegebenen Bibliothek kommt und nicht aus einem Downloadordner von vorletztem Sommer. Wie sich Generierung und Präsentation inzwischen direkt verbinden lassen, steht in Black Forest FLUX.2 in PowerPoint und Copilot.
Was ist mit Auflösung und Formatvarianten – muss ich jedes Format einzeln ablegen?
Nein, und das ist eine der Stellen, an denen KI-Bilder einfacher sind als Fotos. Lege die Ausgangsdatei in voller Auflösung ab und erzeuge Zuschnitte dort, wo sie gebraucht werden. SharePoint erzeugt keine Formatvarianten auf Zuruf – wenn du sie brauchst, baust du einen Fluss, der beim Freigeben zwei oder drei Standardgrößen ablegt. Halte die Zahl klein. Welche Ausgangsauflösungen überhaupt sinnvoll sind, klärt Auflösung und Seitenverhältnis bei KI-Bildern.
Und wenn wir nach zwei Jahren doch auf ein anderes System wechseln?
Dann nimmst du mit, was den eigentlichen Wert ausmacht: die Spaltenwerte. Dateien plus Metadaten lassen sich über die Graph-Schnittstelle oder klassisch über Tabellenexport herausziehen, und jedes ernstzunehmende Zielsystem kann SharePoint als Quelle lesen. Was nicht mitwandert, sind die Flüsse und Ansichten – das ist verschmerzbar, weil die eigentliche Arbeit im Modell steckt und nicht in der Automatisierung. Genau deshalb lohnt es sich, das Spaltenmodell sauber zu bauen, selbst wenn du dir bei der Plattform noch nicht sicher bist.
Dieses Consulting-Dokument steht als PDF zum Download bereit: https://www.boddenberg.de/ArtikelPdf/digital-asset.pdf — © Ulrich B. Boddenberg · boddenberg.de