

Teams Survivability und Survivable Branch Appliance
Ausfallsicherheit für die Teams-Telefonie: von Mobilfunk-Fallback bis SBASurvivability: Ausfallkonzepte für die Teams-Telefonie
„Und was ist, wenn das Internet weg ist?“ — diese Frage kommt in jedem Migrationsprojekt, meist von jemandem, der die alte Anlage im Keller noch als beruhigend empfand. Sie verdient eine bessere Antwort als „das passiert schon nicht“, denn sie ist berechtigt: Cloud-Telefonie verlagert die Abhängigkeit von der eigenen Anlage auf die eigene Leitung. Dieser Artikel sortiert die vier realistischen Ausfallszenarien, zeigt die Redundanz-Treppe von der günstigen Mobilfunk-Rückfallebene bis zur Survivable Branch Appliance — und beantwortet die einzige Frage, die wirklich zählt: Was kostet eine Stunde ohne Telefonie an diesem Standort?
|
Survivability in der Teams-Telefonie kurz erklärt: Die Ausfallsicherheit der Teams-Telefonie wird auf mehreren Ebenen hergestellt. Redundante Anbindung: eine zweite Internetleitung über einen getrennten Weg sowie doppelt ausgelegte SBCs und SIP-Trunks fangen die häufigsten Störungen ab — Leitungs- und Hardwareausfälle. Bewusster Mobilfunk-Fallback: vorbereitete Rufumleitungen auf Mobiltelefone sind die günstigste wirksame Maßnahme und decken nahezu alle Szenarien ab, sofern sie dokumentiert und geübt sind. Survivable Branch Appliance (SBA): ein lokales Gerät am Standort, das bei fehlender Verbindung zur Teams-Cloud die Anrufsteuerung übernimmt und über einen lokalen SIP-Trunk Grundtelefonie ermöglicht — annehmen, wählen, halten, weiterleiten sowie Notruf; nicht verfügbar sind dabei Warteschleifen, automatische Vermittlungen, Präsenz, Chat, Meetings und Voicemail. Die Clients schwenken bei Ausfall automatisch in den Notbetrieb und danach zurück. Welche Stufe angemessen ist, ergibt sich aus dem Schaden je Ausfallstunde am jeweiligen Standort — nicht aus dem IT-Budget. (Stand Mitte 2026) |
|---|
Die vier Szenarien — und was jeweils noch geht
Bevor über Redundanz gesprochen wird, lohnt die Sortierung der Fälle, denn sie haben völlig unterschiedliche Auswirkungen und völlig unterschiedliche Gegenmittel. Szenario eins ist der Klassiker: Die Internetleitung am Standort fällt aus — Bagger, Providerstörung, defekter Router. Die Teams-Clients verlieren die Cloud-Verbindung, eingehende Anrufe laufen ins Leere. Das ist der häufigste Fall und zugleich der am besten lösbare, weil eine zweite Leitung über einen getrennten Weg ihn vollständig auffängt. Szenario zwei betrifft SBC oder Trunk: Hardware defekt, Zertifikat abgelaufen, Carrier gestört. Bemerkenswert daran ist, was weiterläuft — interne Teams-Gespräche, Chat, Meetings, Video sind unbeeinflusst; nur das Amt ist zu. Szenario drei ist die Cloud-Störung selbst: selten, aber nicht ausgeschlossen, und hier fällt die Anrufsteuerung komplett aus, auch intern. Und Szenario vier ist der Fall, den alle vergessen: Stromausfall — dann sind Switches, Access Points, SBC und Laptops aus, und die schönste Redundanz nützt nichts. Ehrlicherweise gehört dazugesagt: Auch die alte TK-Anlage konnte das nicht, sofern sie nicht auf einer USV lief.

Skizze 1: Vier Ausfallszenarien und ihre jeweiligen Auswirkungen.
Alt-Text-Vorschlag: Übersicht von vier Ausfallszenarien: Bei Ausfall der Internetleitung am Standort verlieren die Teams-Clients die Cloud-Verbindung und eingehende Anrufe laufen ins Leere, während eine zweite Leitung oder ein Mobilfunk-Fallback den Betrieb sichert — der häufigste und am besten lösbare Fall. Bei Ausfall von SBC oder Trunk laufen interne Teams-Gespräche, Chat und Meetings weiter, nur externe Anrufe sind nicht möglich, was ein zweiter SBC oder Trunk auffängt. Bei einer Störung der Teams-Cloud fällt die Anrufsteuerung auch intern aus, Warteschleifen und Vermittlungen sind tot, und nur eine Survivable Branch Appliance oder ein Mobilfunk-Fallback helfen. Bei Stromausfall sind Switches, Access Points, SBC und Laptops aus, wogegen nur eine USV für Kernkomponenten und Mobiltelefone helfen — ein Fall, den auch die alte Anlage nicht abfangen konnte.
Die Leitfrage: Was kostet eine Stunde ohne Telefonie?
Bevor irgendein Gerät beschafft wird, gehört diese eine Frage je Standort beantwortet — und zwar nicht von der IT, sondern vom Fachbereich: Was kostet eine Stunde ohne Telefonie hier, in Geld, in Sicherheit, in Reputation? Die Antworten fallen dramatisch unterschiedlich aus. Ein Vertriebsbüro verkraftet zwei Stunden ohne Festnetz, weil alle Beteiligten ohnehin Mobiltelefone haben und Kunden zurückrufen. Eine Notrufannahme, eine Leitstelle oder ein Bereitschaftsdienst verkraften keine zwei Minuten. Ein Produktionsstandort liegt irgendwo dazwischen — dort ist die Telefonie meist unkritisch, außer für Störungsmeldungen und den Aufzugsnotruf, der ohnehin auf eigenen Wegen läuft. Diese Einschätzung ergibt die Ausfallklasse je Standort, und aus der Ausfallklasse folgt die Redundanzstufe. Alles andere — insbesondere die Beschaffung teurer Redundanz für alle Standorte gleichermaßen — ist entweder Geldverschwendung an der einen oder Fahrlässigkeit an der anderen Stelle.
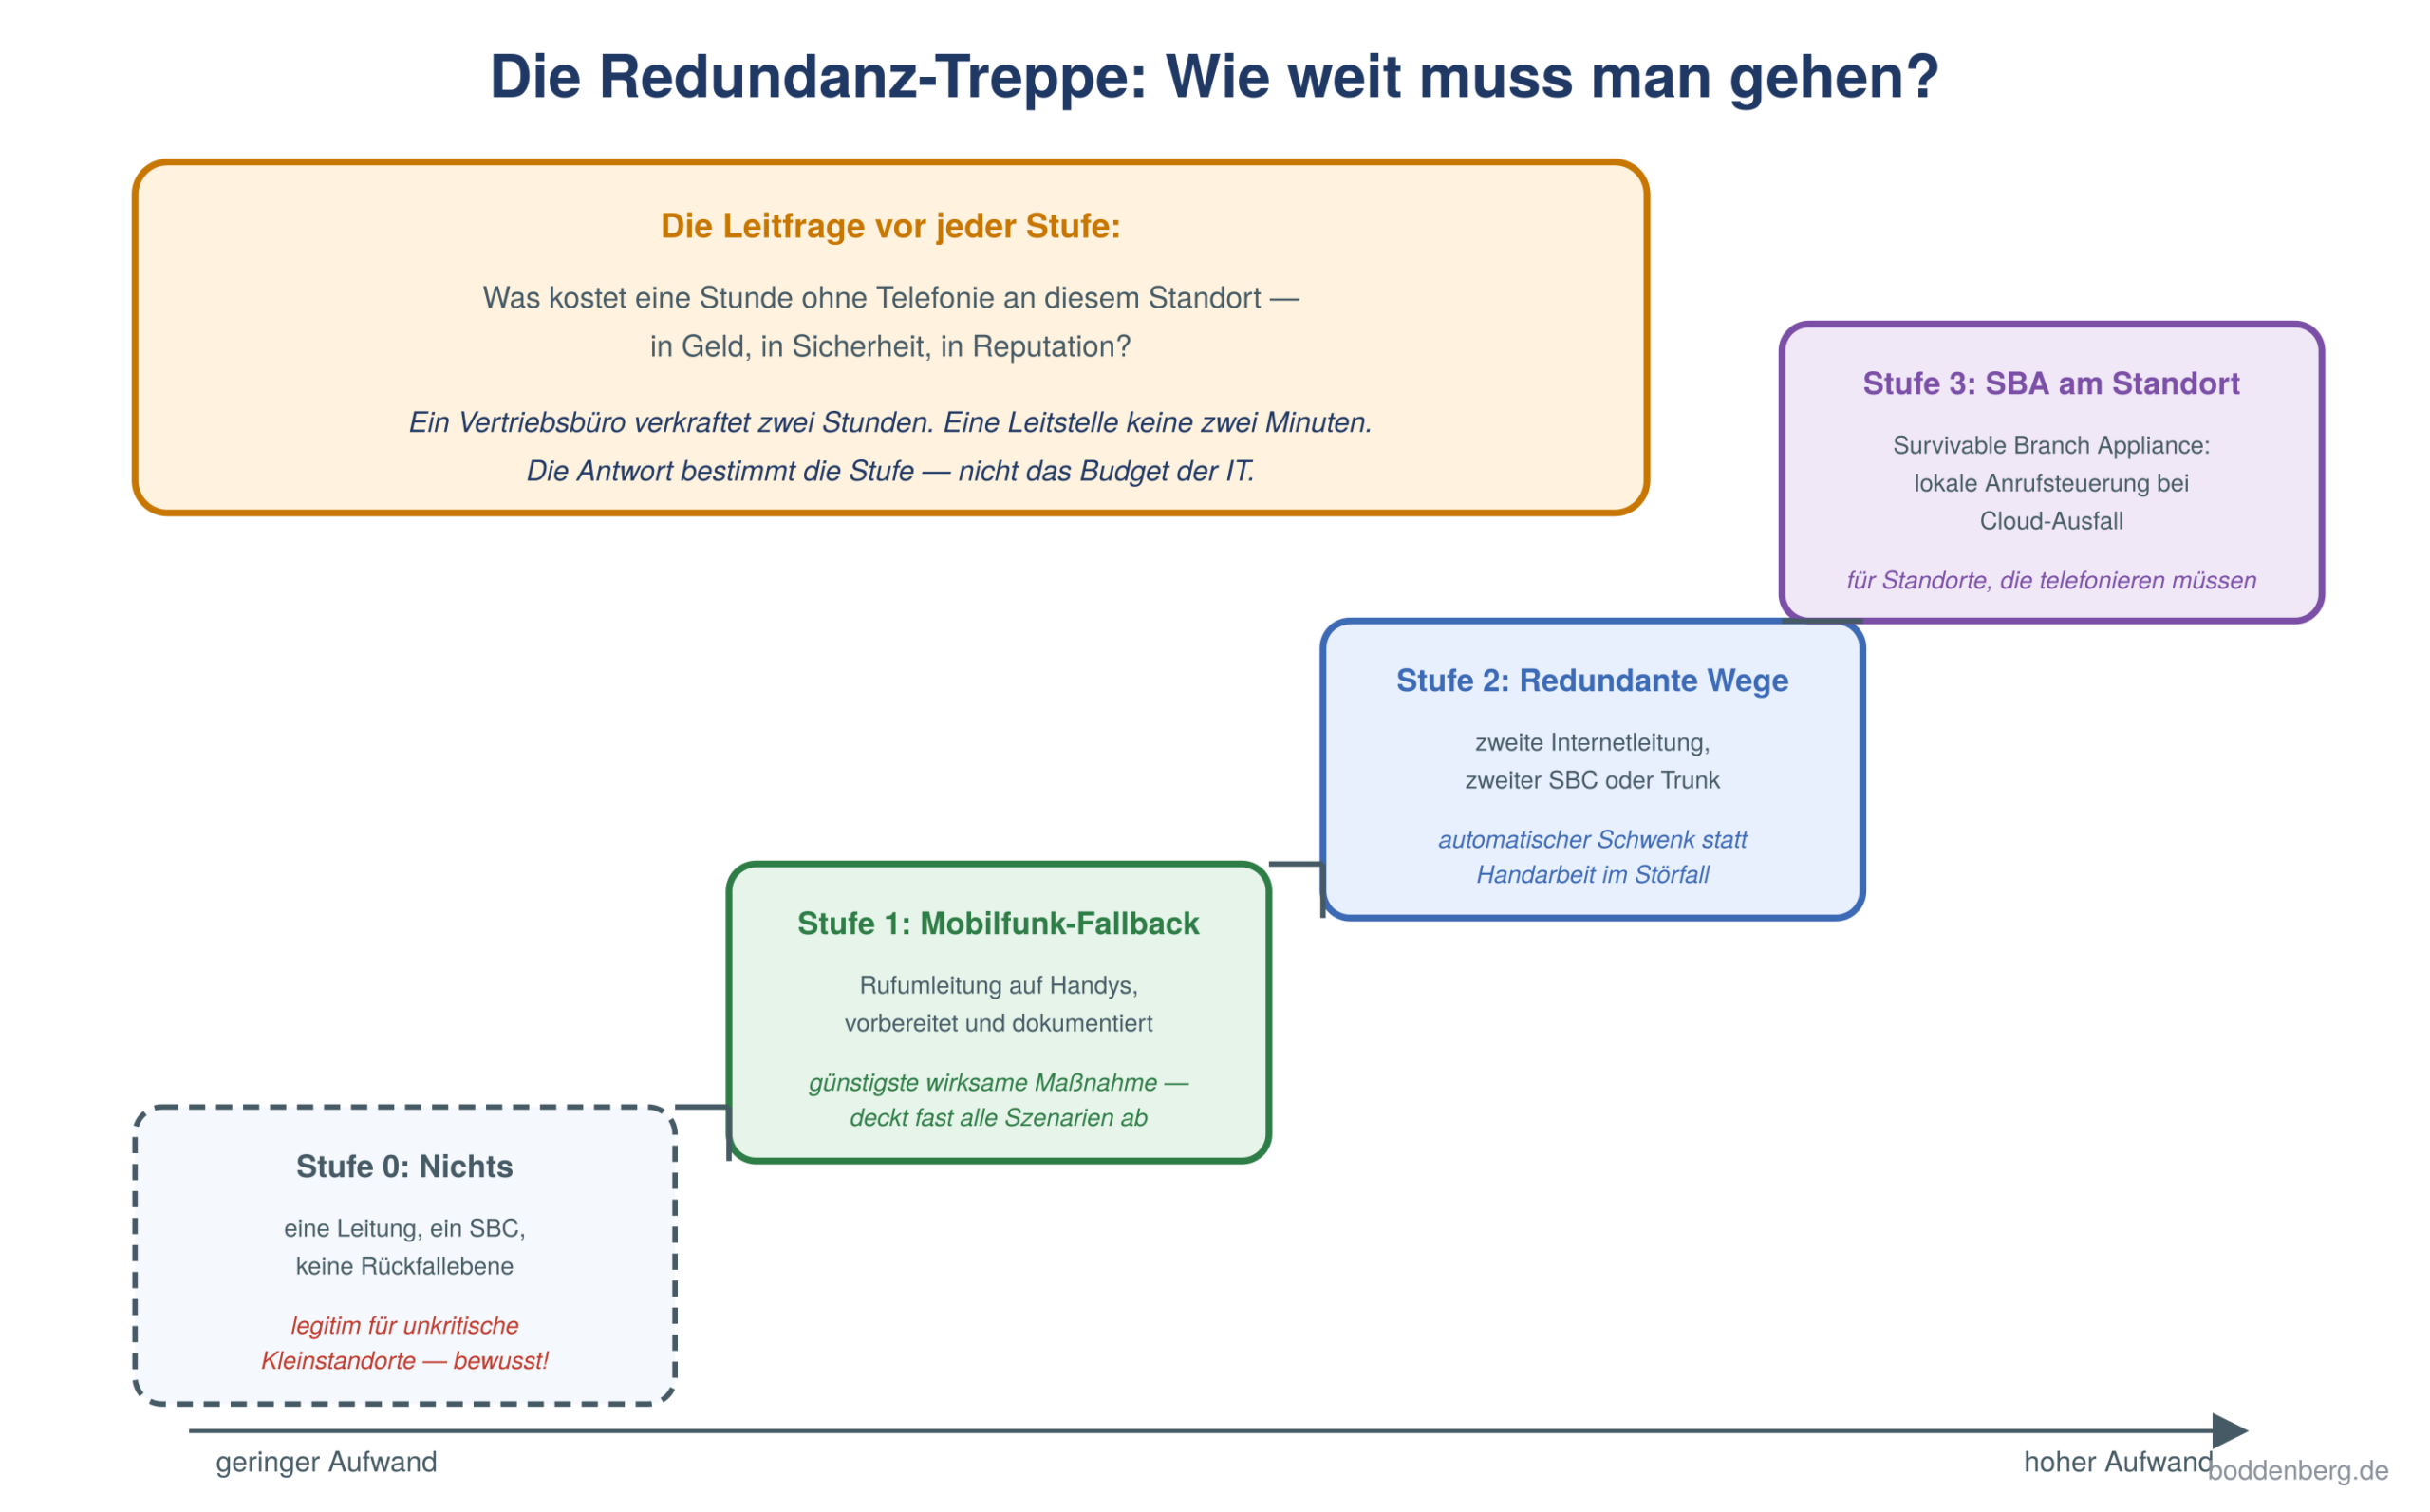
Skizze 2: Die Redundanz-Treppe von der bewussten Nichtabsicherung bis zur SBA.
Alt-Text-Vorschlag: Vierstufige Redundanz-Treppe mit steigendem Aufwand: Stufe null bedeutet keine Absicherung mit einer Leitung, einem SBC und keiner Rückfallebene — für unkritische Kleinstandorte legitim, aber bewusst zu entscheiden. Stufe eins ist der Mobilfunk-Fallback über vorbereitete und dokumentierte Rufumleitungen auf Handys, die günstigste wirksame Maßnahme, die fast alle Szenarien abdeckt. Stufe zwei sind redundante Wege mit zweiter Internetleitung, zweitem SBC oder Trunk und automatischem Schwenk statt Handarbeit im Störfall. Stufe drei ist die Survivable Branch Appliance am Standort mit lokaler Anrufsteuerung bei Cloud-Ausfall, für Standorte, die telefonieren müssen. Leitfrage vor jeder Stufe: Was kostet eine Stunde ohne Telefonie an diesem Standort in Geld, Sicherheit und Reputation — ein Vertriebsbüro verkraftet zwei Stunden, eine Leitstelle keine zwei Minuten.
Die Redundanzstufen im Detail
Stufe 1: Der bewusste Mobilfunk-Fallback
Die günstigste wirksame Maßnahme wird am häufigsten unterschätzt, weil sie so unspektakulär ist: eine vorbereitete Rufumleitung der wichtigsten Nummern auf Mobiltelefone. Wichtig sind dabei die zwei Wörter „vorbereitet“ und „bewusst“. Vorbereitet heißt: Die Umleitungen sind dokumentiert, die Zielnummern gepflegt, und jemand weiß, wo sie im Störfall aktiviert werden — und zwar auch dann, wenn die eigene Internetleitung tot ist, was den Zugriff aufs Admin Center erschwert; deshalb gehört der Notfallzugang über Mobilfunk-Tethering mitgedacht. Alternativ und noch robuster: Die Umleitung wird nicht im Tenant, sondern beim Carrier hinterlegt, der sie auf Zuruf schaltet — eine Leistung, nach der man im Vertrag ausdrücklich fragen sollte. Bewusst heißt: Die Strategie ist dokumentiert und abgenommen, nicht improvisiert. Ein Mobilfunk-Fallback ist keine Kapitulation, sondern eine legitime, oft ausreichende Antwort — vor allem für Standorte, deren Belegschaft ohnehin Diensthandys trägt.
Stufe 2: Redundante Wege
Die zweite Stufe verdoppelt die Infrastruktur an den Stellen, wo Ausfälle real passieren. Bei der Internetanbindung heißt das: eine zweite Leitung, und zwar über einen getrennten Weg — zwei Anschlüsse desselben Anbieters im selben Kabelschacht sind keine Redundanz, sondern zwei Rechnungen; sinnvoll sind unterschiedliche Zuführungen, im Zweifel Glasfaser plus Mobilfunk-Router. Bei der SBC-Ebene bringt jeder ernsthafte SBC Redundanzfunktionen mit: zwei Instanzen mit automatischem Schwenk, gern über zwei Standorte oder Verfügbarkeitszonen verteilt. Und beim Trunk lohnt der Blick in den Vertrag: Bietet der Provider redundante Zuführung, gibt es ein zweites Ziel für den Fall, dass eine Strecke ausfällt, wie schnell greift die Umschaltung? Diese Fragen gehören in die SIP-Trunk-Auswahl — nachträglich sind sie teurer. Für die meisten Mittelständler ist Stufe zwei der sinnvolle Zielzustand: Sie fängt die beiden häufigsten Szenarien vollständig ab und kostet einen überschaubaren monatlichen Betrag.
Stufe 3: Die Survivable Branch Appliance
Die SBA ist die Antwort auf das Szenario, das keine Leitung löst: Die Cloud selbst ist nicht erreichbar. Sie ist ein lokales Gerät oder eine lokale Instanz am Standort, verbunden mit einem lokalen SIP-Trunk, und sie tut im Normalbetrieb genau nichts — außer bereit zu sein. Verlieren die Clients am Standort die Verbindung zur Teams-Cloud, schwenken sie automatisch auf die SBA, die dann die Anrufsteuerung übernimmt; kommt die Cloud zurück, schwenken sie zurück. Entscheidend für realistische Erwartungen ist, was im Notbetrieb bleibt: externe Anrufe über den lokalen Trunk, Gespräche zwischen den Nutzern am Standort, Annehmen, Halten, Weiterleiten und — besonders wichtig — der Notruf über den lokalen Weg. Was nicht bleibt: Warteschleifen, automatische Vermittlungen, Präsenz, Chat, Meetings, Voicemail, Anrufprotokolle und die Erreichbarkeit anderer Standorte. Die SBA ist damit eine Rettungsinsel, kein zweites Haus — genug, um arbeitsfähig zu bleiben, und deutlich weniger als der Normalbetrieb.

Skizze 3: Die Survivable Branch Appliance im Normal- und im Notbetrieb.
Alt-Text-Vorschlag: Darstellung der SBA-Funktionsweise: Im Normalbetrieb steuert die Teams-Cloud alle Anrufe, die Clients am Standort haben vollen Funktionsumfang, und die SBA mit lokalem Trunk wartet im Hintergrund, ohne etwas zu tun. Ist die Cloud nicht erreichbar, schwenken die Clients automatisch in den Notbetrieb, die SBA übernimmt die lokale Anrufsteuerung, und nach Rückkehr der Cloud schwenken sie zurück. Im Notbetrieb funktionieren externe Anrufe über den lokalen Trunk, Anrufe zwischen Nutzern am Standort, Annehmen, Halten und Weiterleiten sowie der Notruf über den lokalen Weg — kurz Grundtelefonie. Nicht verfügbar sind Warteschleifen und Vermittlungen, Präsenz, Chat und Meetings, Voicemail und Anrufprotokolle sowie die Erreichbarkeit anderer Standorte — die SBA ist eine Rettungsinsel, kein zweites Haus.
|
Achtung: Redundanz, die nie getestet wurde, ist Dekoration. Der häufigste Fund bei Ausfallkonzept-Prüfungen ist nicht die fehlende Redundanz, sondern die vorhandene, die nicht funktioniert: die zweite Leitung, deren Router seit dem Umbau im falschen VLAN hängt; der Ersatz-SBC, dessen Zertifikat vor vier Monaten abgelaufen ist — und Zertifikate laufen bekanntlich auf beiden Geräten ab, nicht nur auf dem aktiven; die SBA, die niemand nach dem letzten Firmware-Update angefasst hat; die hinterlegte Notfall-Rufumleitung auf die Handynummer eines Kollegen, der das Unternehmen verlassen hat. All das kostet Geld im Monat und liefert Sicherheit nur auf dem Papier. Deshalb gehört zu jeder Redundanzstufe ein Testrhythmus — halbjährlich reicht meist — bei dem der Ausfall bewusst herbeigeführt wird: Leitung ziehen, primären SBC deaktivieren, den Schwenk beobachten, das Ergebnis protokollieren. Wer das nie tut, erfährt vom Zustand seiner Redundanz erst in dem Moment, in dem er sie braucht — und das ist der schlechteste denkbare Zeitpunkt für eine Überraschung. |
|---|
Standortklassen: Wer bekommt welche Stufe?
|
Standorttyp |
Verkraftbare Ausfallzeit |
Empfohlene Stufe |
|---|---|---|
|
Kleines Vertriebs- oder Verwaltungsbüro |
Stunden — Mobiltelefone federn ab |
Stufe 1: dokumentierter Mobilfunk-Fallback |
|
Hauptsitz mit Zentrale und Kundenkontakt |
Minuten bis wenige Stunden |
Stufe 2: redundante Leitung, SBC-Redundanz |
|
Produktionsstandort |
Stunden für Bürotelefonie, Minuten für Störungsmeldung |
Stufe 1–2, Sonderwege für Alarmierung getrennt betrachten |
|
Kundenservice / Contact Center |
Minuten — jede Minute kostet messbar |
Stufe 2, bei hoher Kritikalität plus SBA |
|
Leitstelle, Bereitschaft, Gesundheitswesen |
Praktisch null |
Stufe 3: SBA plus redundante Wege plus USV |
|
Homeoffice-Arbeitsplätze |
Individuell — Mobilfunk ist der Fallback |
Keine Infrastruktur nötig, aber Erwartung klären |
Zwei Zeilen dieser Tabelle verdienen einen Kommentar. Beim Produktionsstandort trennt sich die Betrachtung: Die Bürotelefonie ist meist unkritisch, aber Störungsmeldeketten, Alarmierung und Notrufeinrichtungen laufen ohnehin auf eigenen Wegen — und genau diese Trennung ist ein Vorteil, kein Mangel: Was auf eigenen Wegen läuft, fällt nicht mit der Telefonie aus. Und beim Homeoffice gilt eine oft übersehene Wahrheit: Verteilte Arbeitsplätze sind für sich genommen ein Redundanzkonzept. Wenn der Standort ausfällt, telefonieren die Kollegen im Homeoffice weiter, weil sie eine eigene Leitung nutzen — die Cloud-Telefonie hat gegenüber der zentralen TK-Anlage hier einen strukturellen Vorteil, den man im Ausfallkonzept ruhig würdigen darf.
|
Aus der Praxis: Ein Klinikverbund wollte SBAs für alle vierzehn Standorte — Investition im gut fünfstelligen Bereich plus Betriebsaufwand, begründet mit „wir sind kritische Infrastruktur“. Die Ausfallanalyse je Standort ergab ein differenzierteres Bild: Kritisch im Sinne von „keine zwei Minuten“ waren drei Standorte — die mit Notaufnahme und Bereitschaftsdienst. Neun weitere waren Verwaltungs- und Ambulanzstandorte, deren Telefonie zwei Stunden Ausfall verkraftet hätte, weil die medizinisch kritische Kommunikation ohnehin über eigene Alarmierungs- und Funkwege läuft — die mit der Telefonie gar nichts zu tun haben. Zwei waren reine Bürostandorte. Wir haben drei SBAs beschafft statt vierzehn, für die neun mittleren Standorte redundante Leitungen mit Mobilfunk-Rückfall eingerichtet und für die zwei Bürostandorte einen dokumentierten Umleitungsplan geschrieben. Das gesparte Budget floss in etwas, das im Ergebnis mehr brachte: USVs für die Netzwerkverteiler der drei kritischen Standorte — denn beim Stromausfall hätte auch die schönste SBA im dunklen Serverraum gestanden. Der technische Leiter formulierte die Lehre so: „Wir hätten Redundanz gekauft, wo wir Strom gebraucht hätten.“ |
|---|
|
Tipp: Die Notfallkarte — eine Seite, die im Ernstfall zählt. Alle Redundanztechnik nützt nichts, wenn im Störfall niemand weiß, was zu tun ist — und der Störfall ist genau der Moment, in dem das Intranet nicht erreichbar ist. Schreibe deshalb eine einseitige Notfallkarte, ausgedruckt an Empfang, Leitwarte und bei den Verantwortlichen: Wer ist im Störfall zu informieren (mit Mobilnummern)? Wie wird der Mobilfunk-Fallback aktiviert und von wem? Welche Nummern werden zuerst umgeleitet (Zentrale, Bereitschaft, Service)? Wie erreicht die IT das Admin Center ohne Firmenleitung? Und welche Ansage bekommen Anrufer, solange die Umleitung greift? Diese eine Seite ist im Ernstfall mehr wert als jedes Konzeptdokument im Dateiablage-Ordner — und sie zwingt beim Schreiben zu den Fragen, die man sonst erst unter Druck stellt. Aktualisiert wird sie zusammen mit dem halbjährlichen Redundanztest: gleicher Termin, gleicher Aufwand. |
|---|
Der ehrliche Vergleich: War die alte Anlage wirklich sicherer?
Zum Schluss die Frage, die hinter der Eingangsfrage steckt — und sie verdient eine ehrliche Antwort statt eines Verkaufsarguments. Die alte TK-Anlage hatte einen echten Vorteil: Sie funktionierte ohne Internet, und bei einem ISDN-Anschluss telefonierte im Notfall sogar das eine Apparat weiter, der aus der Leitung gespeist wurde. Dieser Vorteil ist mit der ISDN-Abschaltung allerdings weitgehend Geschichte — moderne Anlagen hängen ebenfalls an IP-Anschlüssen und fallen mit der Leitung aus. Dem gegenüber stehen Nachteile der alten Welt, die im Vergleich gern verschwiegen werden: Sie war ein einzelner Punkt des Versagens im eigenen Keller, abhängig von einer Hardware, deren Ersatzteile immer schwerer zu beschaffen waren, und von einem Wartungsvertrag mit Reaktionszeiten, die man erst im Ernstfall nachliest. Die Cloud-Telefonie verteilt dieses Risiko: Die Anrufsteuerung liegt in einer Infrastruktur mit einer Verfügbarkeit, die kein Mittelständler im eigenen Keller erreicht, und verteilte Arbeitsplätze federn Standortausfälle strukturell ab. Die ehrliche Bilanz lautet deshalb: Die Risiken haben sich verschoben, nicht vergrößert — und sie sind mit den beschriebenen Stufen beherrschbar. Was sich wirklich geändert hat, ist die Sichtbarkeit: Ein Ausfall der eigenen Anlage war ein interner Vorfall, ein Cloud-Ausfall steht in den Nachrichten.
FAQ: Häufige Fragen zu Ausfallkonzepten
Was passiert bei einem Internetausfall mit der Teams-Telefonie?
Ohne Vorkehrungen: Die Clients am betroffenen Standort verlieren die Cloud-Verbindung, eingehende Anrufe laufen ins Leere. Mit einer zweiten Leitung über einen getrennten Weg läuft alles weiter; mit vorbereitetem Mobilfunk-Fallback bleibt zumindest die Erreichbarkeit der wichtigsten Nummern erhalten. Homeoffice-Arbeitsplätze sind von einem Standortausfall ohnehin nicht betroffen.
Was ist eine Survivable Branch Appliance?
Ein lokales Gerät beziehungsweise eine lokale Instanz am Standort mit eigenem SIP-Trunk, die bei fehlender Verbindung zur Teams-Cloud die Anrufsteuerung übernimmt. Die Clients schwenken automatisch in den Notbetrieb und danach zurück. Verfügbar bleiben Grundfunktionen: externe und interne Anrufe, Halten, Weiterleiten, Notruf — nicht aber Warteschleifen, Vermittlungen, Präsenz, Chat und Voicemail.
Braucht jeder Standort eine SBA?
Nein — und die meisten brauchen keine. Die SBA löst ausschließlich das Cloud-Ausfall-Szenario, das seltenste der vier. Sie lohnt für Standorte, die praktisch keine Ausfallzeit verkraften: Leitstellen, Bereitschaftsdienste, Notaufnahmen. Für alle anderen sind redundante Wege plus dokumentierter Mobilfunk-Fallback das bessere Verhältnis von Aufwand zu Wirkung.
Ist ein Mobilfunk-Fallback nicht eine Notlösung?
Er ist eine bewusste Strategie, wenn er vorbereitet, dokumentiert und geübt ist — und dann eine sehr wirtschaftliche: Er deckt fast alle Szenarien ab, kostet fast nichts und funktioniert auch dann, wenn Strom und Leitung am Standort komplett fehlen. Zur Notlösung wird er nur, wenn er im Störfall improvisiert wird. Wichtig ist die vorab geklärte Frage, wie und von wem er aktiviert wird, wenn die eigene Leitung tot ist.
Funktioniert der Notruf, wenn die Cloud gestört ist?
Mit SBA und lokalem Trunk: ja, über den lokalen Weg. Ohne SBA hängt der Notruf aus Teams an der Cloud-Verbindung — weshalb in jedem Notfallkonzept steht, dass Mobiltelefone die Rückfallebene für Notrufe sind. Das gehört ausdrücklich kommuniziert und geschult, nicht vorausgesetzt: Im Ernstfall greift niemand zur Anleitung.
Wie oft sollte man Ausfallszenarien testen?
Halbjährlich reicht in den meisten Häusern — mit bewusst herbeigeführtem Ausfall: primäre Leitung ziehen, primären SBC deaktivieren, Schwenk beobachten, Ergebnis protokollieren. Wichtig ist, dass auch die organisatorische Seite geübt wird: Wer aktiviert die Umleitung, wer informiert wen? Und im selben Termin wird die Notfallkarte aktualisiert.
War die alte TK-Anlage ausfallsicherer?
In einem Punkt ja — sie funktionierte ohne Internet. Seit der ISDN-Abschaltung hängen aber auch klassische Anlagen an IP-Anschlüssen und fallen mit der Leitung aus. Dafür war die Anlage ein einzelner Ausfallpunkt im eigenen Keller mit alternder Hardware. Die Risiken haben sich also verschoben, nicht vergrößert — und verteilte Arbeitsplätze federn Standortausfälle heute strukturell ab.
Fazit: Bewusst entscheiden statt hoffen
Ausfallsicherheit ist kein Produkt, sondern eine Kette von Entscheidungen je Standort: Ausfallklasse bestimmen, passende Stufe wählen, Notfallkarte schreiben, halbjährlich testen. Wer das tut, kann die Eingangsfrage souverän beantworten — nicht mit „das passiert schon nicht“, sondern mit „dann passiert Folgendes, und das haben wir zuletzt im März getestet“. Das ist der Unterschied zwischen einem Konzept und einer Hoffnung. Wenn du deine Ausfallklassen bestimmen oder ein bestehendes Konzept auf Herz und Nieren prüfen lassen willst: Melde dich kurz für eine Standortbestimmung — meist ist weniger Technik nötig als befürchtet, aber mehr Dokumentation als vorhanden.